
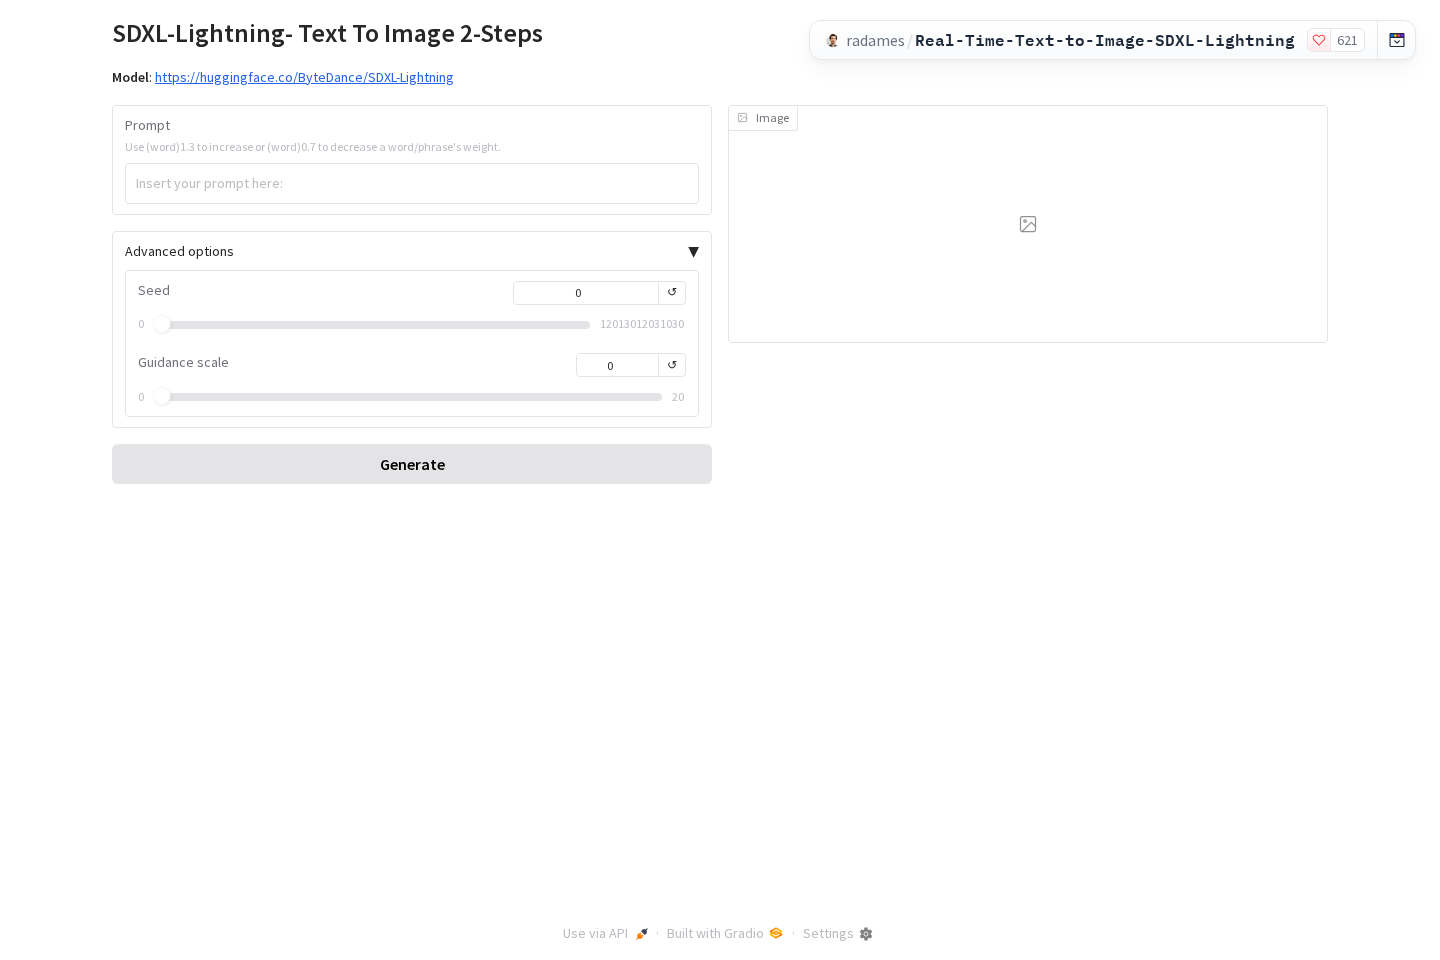
原站网页截图,页面可能随时间更新。
- 作者:radames
- 分类:AI 绘图
- 名称:Real-Time Text-to-Image SDXL Lightning
- 来源:Hugging Face Spaces
Real-Time Text-to-Image SDXL Lightning 面向需要从文字构思图像的用户,核心用途是将提示词转化为图像。使用时可以先描述主体、场景和风格,再通过种子与引导强度调整生成方向,适合快速探索视觉方案。
主要功能
应用提供文字生成图像功能,界面包含提示词输入框、生成结果图像区域、Seed 种子滑块和 Guidance scale 引导强度滑块。其界面标签将生成方式描述为 SDXL-Lightning Text To Image 2-Steps,适合围绕提示词快速进行图像尝试。
提示词输入框支持通过词语权重调整表达重点:可使用“(word)1.3”提高某个词语或短语的影响,也可使用“(word)0.7”降低其影响。
它主要用于什么?
它主要用于根据文字提示生成图像,适合将创意描述转化为视觉草稿或图像方案。
界面有哪些可调参数?
界面提供 Seed 种子和 Guidance scale 引导强度两个滑块,并支持在提示词中调整词语或短语的权重。
适用任务
如果任务需要快速把文字概念转成图像,可以使用它进行构图方向、主体设定或视觉风格的初步探索。对于同一提示词下的不同结果比较,种子参数可作为调整生成变化的入口。
当提示词包含多个主体或视觉重点时,可以尝试使用词语权重,让部分描述获得更高或更低的表达优先级。具体效果取决于提示词内容和参数组合。
- 根据文字描述生成图像草稿
- 探索不同的视觉构想
- 比较不同种子带来的生成变化
- 调整提示词中词语或短语的重要程度
使用思路
开始时可以先输入清晰的主体和场景描述,再观察生成结果是否符合预期。若需要保持相近的创作方向,可以记录并调整 Seed;若需要改变提示词对结果的影响方式,可以调节 Guidance scale。
提示词权重适合用于突出或弱化具体词语。提高权重可用于强调关键元素,降低权重则可用于减轻某个描述的影响。参数调整宜结合每次生成结果逐步进行,避免同时改变过多条件而难以判断变化来源。
- 输入主体、场景和其他希望呈现的视觉描述。
- 根据结果调整 Seed 或 Guidance scale。
- 使用词语权重强调或弱化特定描述。
- 对不同提示词和参数组合生成的图像进行比较。
如何强调提示词中的某个词?
可以使用“(word)1.3”形式提高某个词语或短语的权重。
如何降低某个词的影响?
可以使用“(word)0.7”形式降低某个词语或短语的权重。
参数理解
Seed 用于控制生成过程中的随机起点,因此调整它可以用于探索不同图像结果。Guidance scale 用于调节生成结果与提示词之间的关联程度,使用时可以结合具体结果逐步调整。
两项参数承担的作用不同:Seed 更适合探索变化,Guidance scale 更适合调整提示词约束方向。实际使用时,可以先固定其中一项,再改变另一项,以便更清楚地比较结果差异。
Seed 和 Guidance scale 有什么区别?
Seed 用于调整生成过程的随机起点,Guidance scale 用于调节结果与提示词之间的关联程度。
常见问题
使用这类文字生成图像工具时,提示词的具体程度会影响表达方向。可以先从简短描述开始,再围绕主体、场景或重点词语逐步细化。若结果偏离预期,可结合提示词权重、Seed 和 Guidance scale 分别尝试调整。
提示词应该怎么写?
可以围绕希望生成的主体和场景进行描述;需要突出或弱化某个词语时,可使用对应的词语权重格式。
怎样获得不同的图像结果?
可以尝试调整 Seed,并结合提示词内容或 Guidance scale 进行比较。