
Coding Agent Leaderboard:AI 编程代理评测与资源对比工具
Coding Agent Leaderboard 用于比较编码代理模型与运行框架在不同基准任务中的表现,并结合令牌用量、任务成本、代理耗时等资源指标分析效率、排名和取舍关系。
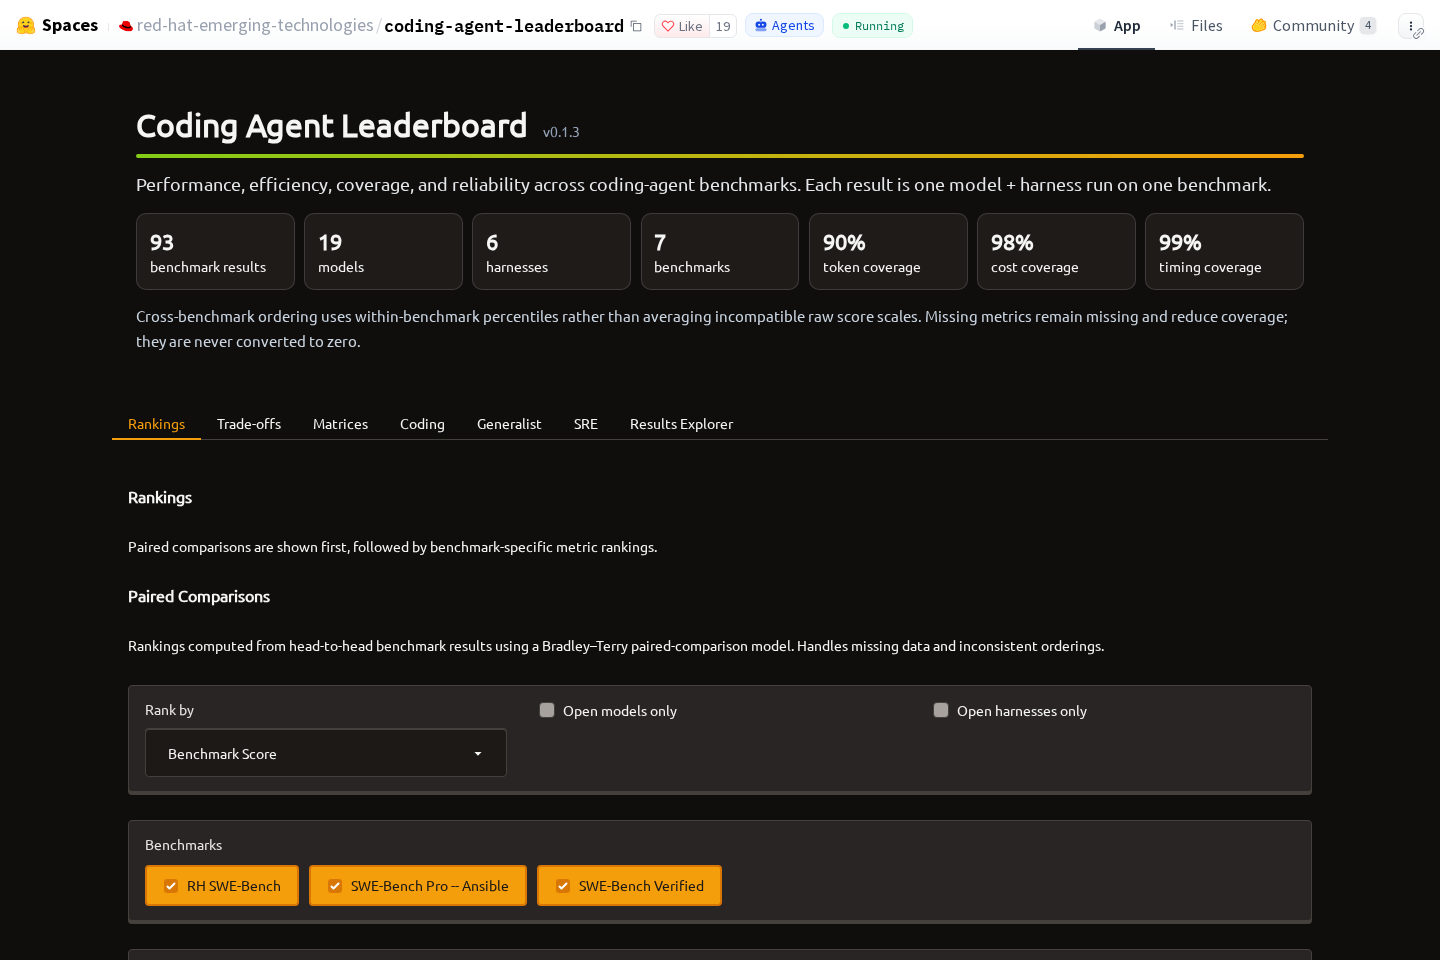
目标网站网页截图,页面可能随时间更新。
- 代码许可:mit
- 作者:red-hat-emerging-technologies
- 分类:AI 编程与 Agent
- 名称:Coding Agent Leaderboard
- 来源:Hugging Face Spaces
Coding Agent Leaderboard 面向需要分析 AI 编程代理表现的用户,提供基准排名、配对比较、效率分析、指标对比和矩阵视图。它将模型、Harness 与具体 benchmark 关联起来,帮助使用者同时观察得分、资源消耗、覆盖情况和任务可靠性。
核心功能
应用围绕编码代理模型与 Harness 展开比较,支持按基准任务查看结果。排行榜包含配对比较和基准特定的指标排名,可分别观察 Harness、模型以及模型与 Harness 组合的表现。排名采用 Bradley–Terry 配对比较模型处理对比结果,并保留基准覆盖信息。
指标数据可涵盖得分、资源、耗时、可靠性和每次成功任务的消耗。模型与基准矩阵使用基准内部的百分位控制颜色,同时在单元格中显示实际得分,缺失数据保持为空。
它比较的对象是什么?
主要比较编码代理模型、Harness 以及二者组合在不同 benchmark 上的结果。
排行榜是否只看单一总分?
不是。页面还提供基准特定排名、指标排名、配对比较、矩阵和取舍分析等视图。
效率与资源分析
Efficiency 视图一次针对一个选定 benchmark,将得分与资源消耗放在同一分析范围内,避免不同基准覆盖不完整时直接混合比较。资源轴支持总令牌数、每任务成本和每任务代理耗时,分别对应每项任务的平均资源使用情况。
图表只绘制选定资源存在且为正数的记录。缺失、零值和负值会被视为不可用,界面会显示因资源数据无效而被排除的运行数量。得分内部按 0 到 1 的小数保存,页面以百分比展示;排名表中的得分则保留一位小数。
- 总令牌数:每项任务的平均总令牌用量。
- 每任务成本:以美元表示的平均任务成本。
- 每任务代理耗时:以秒表示的平均代理运行时间。
Tokens Per Solved Task 如何计算?
它等于 Total Tokens Per Task 除以 Score,其中 Score 使用 0 到 1 的小数值。总令牌数据缺失或非正数,或得分为零及负数时,该指标不可用。
图表可以使用对数坐标吗?
资源轴支持线性和对数显示;具体可用性取决于所选资源数据是否适合绘制。
Pareto 前沿与可视化
Pareto 前沿用于识别资源使用更少且得分更高的有效观测。对于同一 benchmark 和所选资源,如果不存在另一条记录同时使用不更多的资源、取得不低的得分,并至少在一项上严格更优,则该记录可被视为 Pareto 高效点。相同条件下的并列非支配点会被保留,图中以虚线连接。
用户可以选择按 Model 或 Harness 着色,控制点标签显示,并在线性或对数资源轴之间切换。效率图支持 Citrus、Okabe-Ito、High contrast、Rainbow、Grayscale、Viridis、Plasma 和 Cividis 调色板,以及浅色和深色图表背景。
Pareto 前沿适用于哪些资源指标?
总令牌数、每任务成本和每任务代理耗时都支持 Pareto 分析。三者都是越低越好,而得分越高越好。
为什么有些数据点不会出现在效率图中?
如果所选资源缺失、为零或为负数,该记录不会被绘制。
适用任务与使用思路
这类工具适合进行编码代理方案的横向评估,例如比较不同模型或 Harness 在同一 benchmark 上的得分与资源消耗,观察某个方案是否以更高成本换取更高表现,或寻找处于资源与效果平衡位置的非支配点。
使用时可先选择具体 benchmark,再从 Paired Comparisons 和模型、Harness 排名了解整体关系;随后进入 Metric rankings 或 Efficiency,按需要查看得分、成本、令牌和耗时。若要分析覆盖差异,可结合模型矩阵和 benchmark coverage;若要研究错误情况,则可参考执行错误率与缺失指标处理方式。
- 先选择目标 benchmark,限定比较范围。
- 查看配对比较及模型、Harness 排名,了解相对表现。
- 在效率视图中切换资源指标,观察得分与消耗的关系。
- 结合 Pareto 前沿、覆盖率和缺失数据判断结果是否适合进一步比较。
如何避免误读跨 benchmark 的排名?
应优先在同一 benchmark 内比较,因为得分和资源关系按具体基准计算,覆盖不完整的基准不宜直接混合解读。
缺失指标会被当成零值吗?
不会。缺失指标会从对应的指标比较中省略,并在矩阵中保持为空。
数据与结果解读
排行榜聚合时,排序或百分位会在每个 benchmark 内独立计算,再按模型与 Harness 汇总,并同时展示覆盖情况。执行错误率按已记录错误数除以已记录任务数计算,未解决任务不会自动改标为错误。
这些规则意味着结果应结合 benchmark 覆盖、指标可用性和执行记录一起阅读。一个方案缺少某项资源数据时,可能无法参与该资源维度的效率比较;一个方案覆盖的 benchmark 范围不同,也会影响聚合排名的解释。
聚合排名是否会跨基准直接比较原始分数?
排名和百分位会先在各自 benchmark 内计算,再进行聚合,并显示对应的覆盖情况。
执行错误率如何理解?
它是已记录错误数与已记录任务数之比,未解决任务不会被自动归类为错误。