
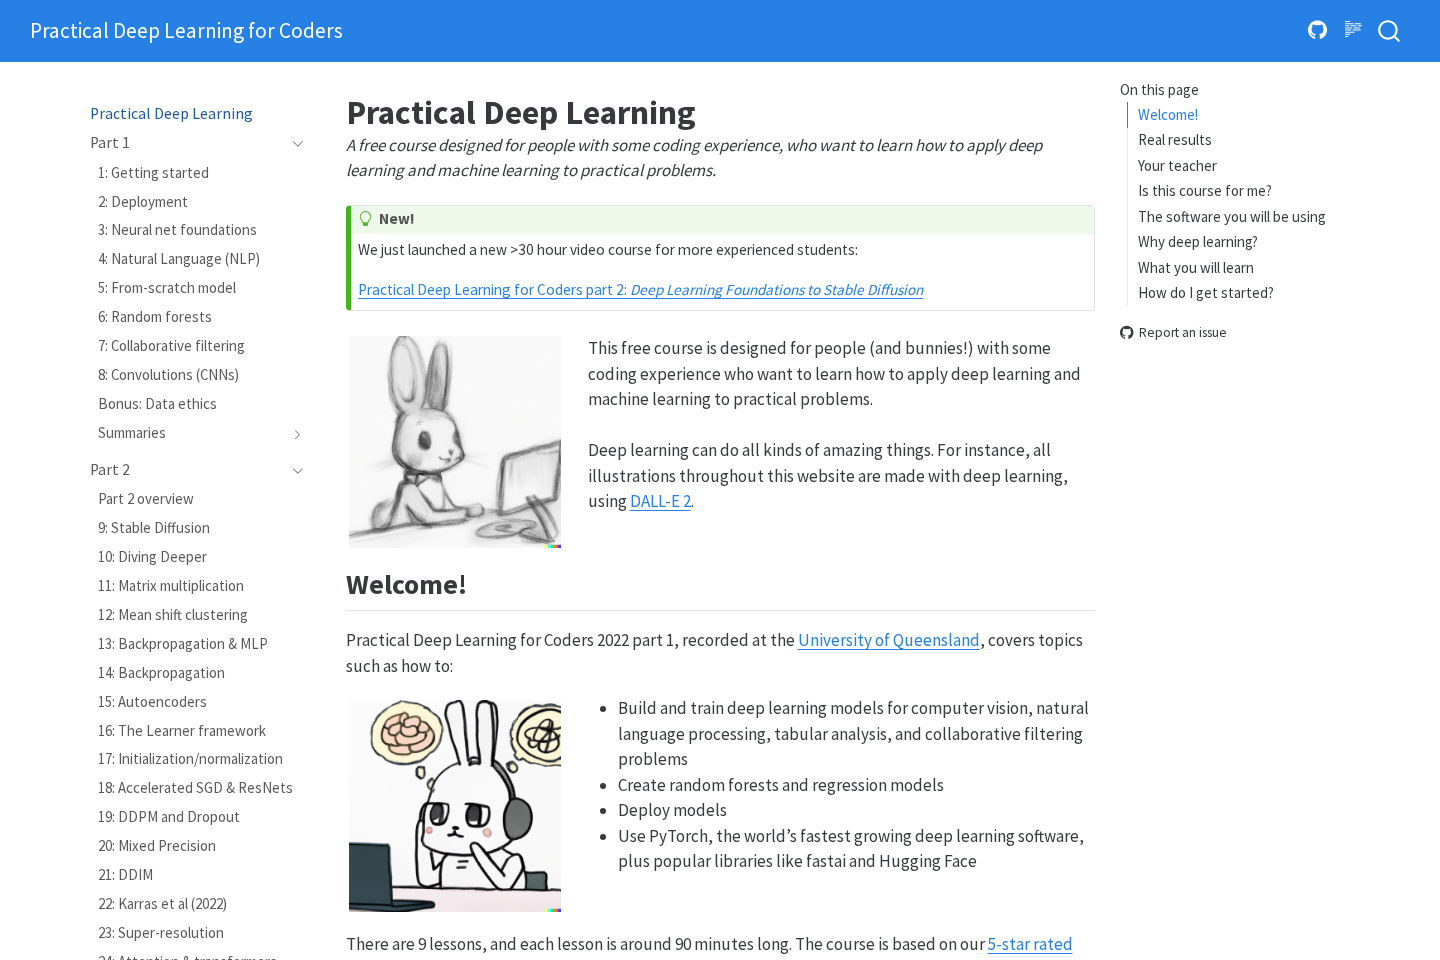
目标网站网页截图,页面可能随时间更新。
- 分类:在线课程
- 名称:Practical Deep Learning for Coders - Practical Deep Learning
- 来源:course.fast.ai
这门课程适合希望把深度学习用于实际问题的编程学习者。课程以可运行的案例为入口,先完成模型构建和应用,再逐步解释背后的方法与实现,覆盖从数据处理、训练到部署的完整路径。
课程定位与适合人群
课程面向具备一定编程经验、希望解决实际问题的学习者,最好有约一年编程经历,并以Python为主要语言。数学方面以高中数学为基础即可,课程会在学习过程中讲解所需的微积分和线性代数。学习重点不是先进行抽象的公式推导,而是通过具体任务建立直观理解,再逐步深入模型工作方式。
课程共9课,每课约90分钟,并配有字幕。学习者可以结合课程视频、互动式Jupyter Notebook和配套书籍材料进行练习。
需要准备高等数学或专用硬件吗?
课程将所需的微积分和线性代数融入教学,具备高中数学基础即可。课程也会介绍可用于模型构建与部署的免费资源,因此不要求预先准备专用硬件。
核心主题与应用方向
课程覆盖计算机视觉、自然语言处理、表格数据分析和协同过滤。学习者将接触图像分类、文档分类、短语相似度、电影评论情感分析、混合类型表格数据以及电影推荐等任务,并学习如何将模型转化为网页应用并完成部署。
除深度学习模型外,课程还介绍随机森林、回归模型和梯度提升等方法,帮助学习者根据数据类型和问题目标选择合适的建模路径。
- 计算机视觉与图像分类
- 自然语言处理与文档分析
- 分类、连续及混合表格数据
- 协同过滤与推荐系统
- 模型部署与网页应用
从使用工具到理解原理
课程使用PyTorch作为基础框架,并结合fastai提供更高层次的深度学习功能;自然语言处理部分会使用Hugging Face Transformers,应用展示与交互可使用Gradio。学习路径会随着课程推进逐步深入,从调用完整的可用网络开始,过渡到理解fastai与PyTorch之间的层次关系。
在方法层面,课程涉及迁移学习、数据增强、权重衰减、参数与激活、仿射函数与非线性等内容,也会讲解随机梯度下降,并从头实现训练循环。这样安排有助于学习者把“如何训练”与“为什么有效”联系起来。
- PyTorch与fastai
- Hugging Face Transformers
- Gradio应用交互
- 迁移学习与数据增强
- 随机梯度下降与训练循环
建议的学习路径
开始学习时,可以先观看第1课,了解课程使用的案例和基本工作流。随后按9课顺序推进,每课完成后配合对应的Notebook复现代码,并记录数据、模型、指标和部署结果。课程强调编写代码和实验,因此仅观看视频可能不足以形成稳定掌握。
进入模型改进阶段后,可以围绕准确率、速度和可靠性比较不同方法,逐步理解数据增强、权重衰减、迁移学习等技术的作用。完成基础任务后,再尝试将方法迁移到自己收集或整理的数据上;如果数据规模、标签质量和问题定义较清晰,实践效果更容易评估。
- 先按顺序观看课程视频,必要时开启字幕。
- 使用Jupyter Notebook复现每个案例的关键步骤。
- 围绕视觉、文本、表格或推荐任务选择一个方向练习。
- 比较模型训练结果,并记录数据处理和参数变化。
- 在理解训练流程后尝试部署为网页应用。
怎样安排每课的学习?
可以将每课约90分钟的视频拆分观看,并预留时间运行Notebook、修改代码和观察结果。按课程顺序学习通常更适合建立从应用到原理的连续理解。
实践准备与复习重点
学习前可准备Python编程环境,并熟悉Notebook中单元格执行、变量查看和结果记录等基本操作。课程主要使用Kaggle Notebooks和Paperspace Gradient进行实验;如果选择其中一种平台,建议先完成环境启动、数据读取和示例代码运行,再开始正式学习。
复习时应重点回看模型如何处理不同类型的数据、训练循环如何更新参数、哪些方法能够改善准确率或效率,以及模型怎样转化为可访问的应用。通过重新运行、修改和解释代码,可以把课程中的工具操作沉淀为可迁移的解决问题能力。
学习成果的合理预期
完成课程后,学习者应能够围绕常见视觉、文本、表格和推荐问题训练深度学习模型,理解影响模型表现的主要因素,并使用相关工具完成应用化和部署流程。课程还会帮助学习者建立从具体案例进入理论、再回到实验验证的学习方式。
实际效果取决于编程基础、练习投入、数据质量和问题选择。若希望巩固所学,可在完成课程案例后独立定义一个小型任务,经历数据准备、模型训练、结果评估和应用部署的完整过程。