
L
1
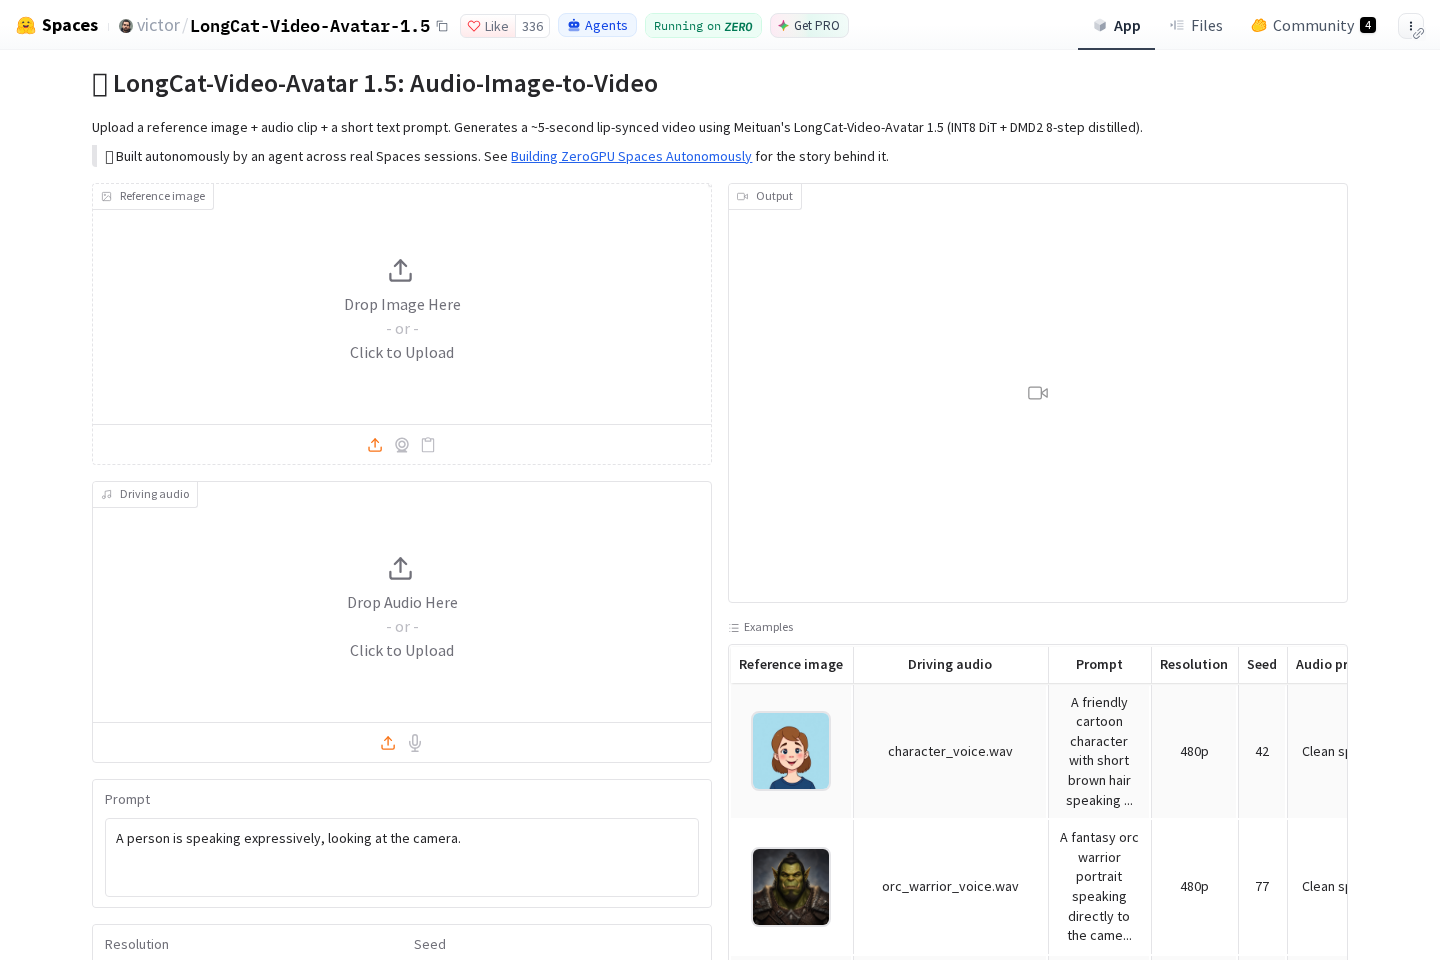
原站网页截图,页面可能随时间更新。
- 作者:victor
- 分类:AI 视频
- 名称:LongCat-Video-Avatar 1.5
- 来源:Hugging Face Spaces
LongCat-Video-Avatar 1.5 将静态人像、声音和文字提示结合起来生成短视频。它的核心用途是让参考图像中的人物按照输入音频呈现口型变化,适用于需要快速形成说话人像片段的内容制作任务。
公开功能
应用支持上传一张参考图像、一段驱动音频和一条简短文字提示,处理后返回一段约5秒的视频。生成结果的重点是人物口型与输入音频保持同步,因此使用时需要同时准备能够代表人物外观的图像和用于驱动表达的音频。
适用任务
它适合制作短时长的音频驱动人像内容,例如将单张人物图像转化为带有说话口型的视频片段。对于需要把声音与固定人物形象结合、快速查看短视频效果的任务,可以将其作为生成工具使用。由于公开功能描述聚焦于约5秒输出,更长内容或复杂镜头的制作不属于已说明的主要用途。
使用思路
准备参考图像时,可以优先选择主体清晰、便于识别面部的画面;驱动音频则应包含希望人物表现的语音内容。文字提示用于补充生成意图,宜围绕画面或表现方式提供简短说明。完成三项输入后提交生成,并根据输出视频检查人物形象和口型同步是否符合预期。
生成机制与限制
该应用使用 LongCat-Video-Avatar 1.5 进行音频驱动的人像视频生成,公开说明提到其采用经过量化的 DiT,并结合 DMD2 蒸馏的8步 LoRA。这里能确认的是模型处理方式和目标输出形式;至于不同图像、音频或提示组合下的具体效果,不宜仅依据这些技术信息推断。
常见问题
需要准备哪些输入?
需要上传参考图像和驱动音频,并填写一条简短文字提示。
输出视频大约多长?
公开功能说明将输出描述为约5秒、与音频口型同步的视频。
文字提示的作用是什么?
文字提示用于补充生成意图,与参考图像和驱动音频一起作为生成输入。