
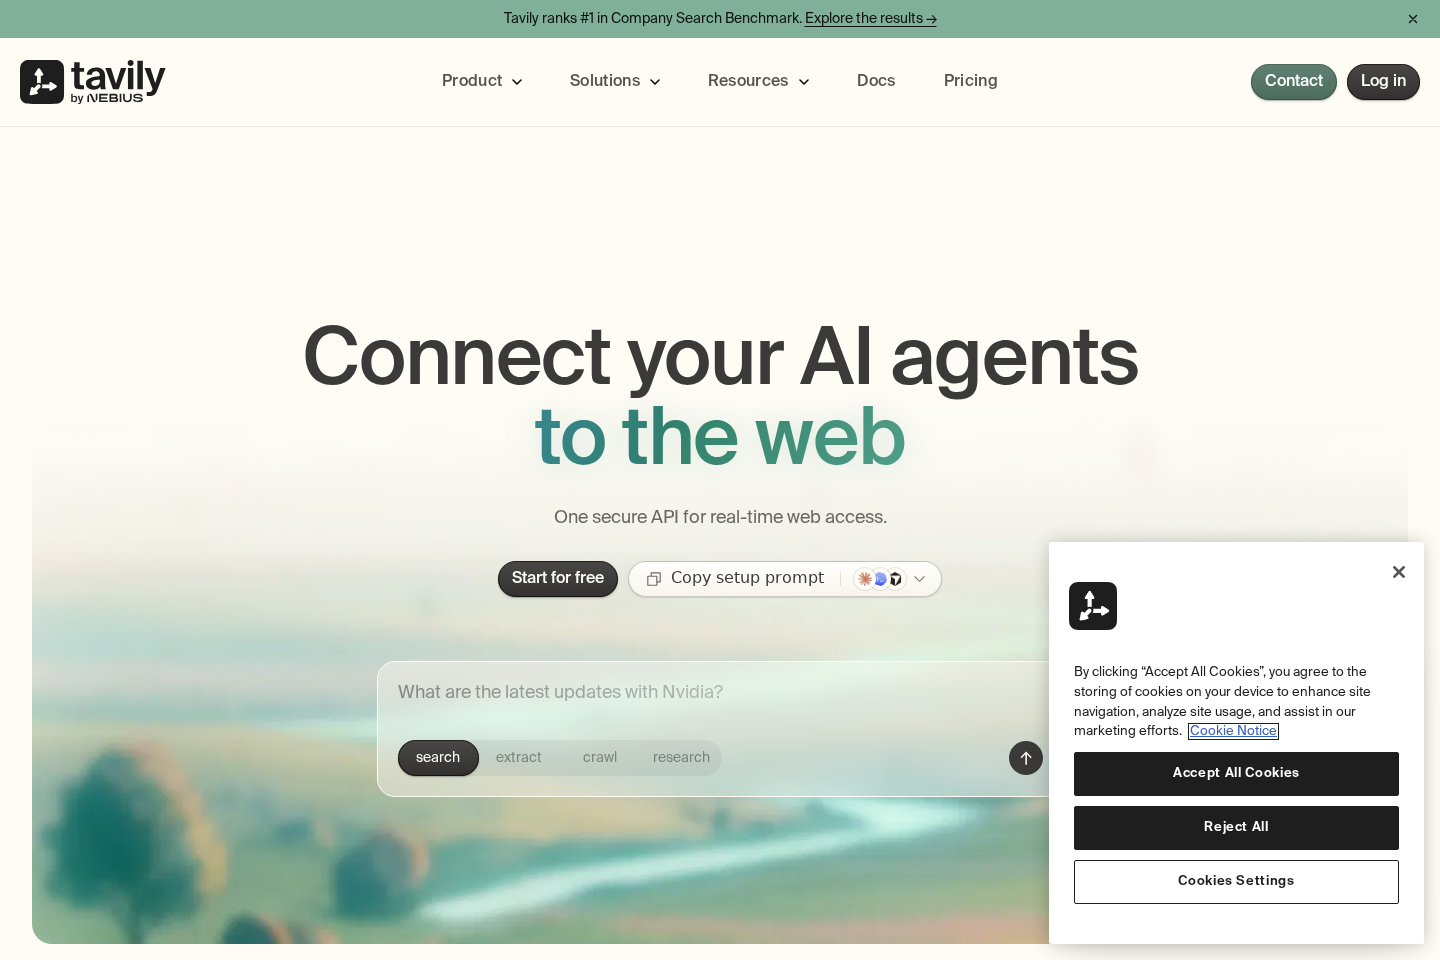
原站网页截图,页面可能随时间更新。
- 分类:AI 搜索
- 名称:Tavily
- 来源:www.tavily.com
Tavily 定位为 AI 代理连接互联网的访问层。它可以检索实时网页信息,提取相关内容,并把结果以结构化、分块的形式返回给模型,适合需要新鲜资料、外部事实和可追溯上下文的应用。
核心能力
Tavily 公开提供搜索、内容提取、网页抓取和研究相关能力。搜索用于发现与问题相关的网页内容,提取用于获取页面中的有效信息,抓取适合处理网页范围更广或需要连续访问的场景,研究能力则面向更完整的资料搜集流程。返回内容会经过整理和分块,便于 AI 代理继续分析。
适用任务
这类服务适合需要实时网络信息的 AI 应用,例如公司研究、新闻与市场信息整理、财务相关资料检索,以及基于网页内容的问答和分析。对于模型本身不一定掌握的库方法或最新事实,可以先通过网页搜索获取上下文,再交给代理进行推理。企业团队也可以将它接入生产环境中的研究型代理或其他需要外部数据的工作流。
使用思路
实际使用时,可以先把用户问题转化为明确的搜索请求,再根据任务需要限制返回结果数量,并选择搜索深度。获得搜索结果后,可继续提取相关页面内容,将有用片段作为模型上下文;如果任务涉及多个页面或更大范围的信息收集,则可以结合抓取与研究流程。这样做的重点不是让模型直接凭记忆回答,而是让它先接触新鲜、相关且结构化的网页资料。
生产环境与安全
Tavily 将实时搜索、缓存和索引结合到检索流程中,用于在查询量增长时维持较稳定的延迟。服务还设置了安全、隐私和内容验证层,用于拦截个人身份信息泄漏、提示注入和恶意来源等风险。接入生产系统时,可以把这些防护能力纳入代理的整体数据访问策略,并对外部内容继续进行必要的权限和结果控制。
常见问题
Tavily 返回的内容适合直接交给 AI 模型吗?
Tavily 会将网页信息整理成结构化、分块的相关内容,便于模型将其作为上下文使用。不过,代理仍应结合任务要求对结果进行判断和处理。
Tavily 能处理企业研究任务吗?
可以。公开介绍中列出了公司搜索相关能力,覆盖公司资料、财务信息以及新闻与市场等研究方向。