
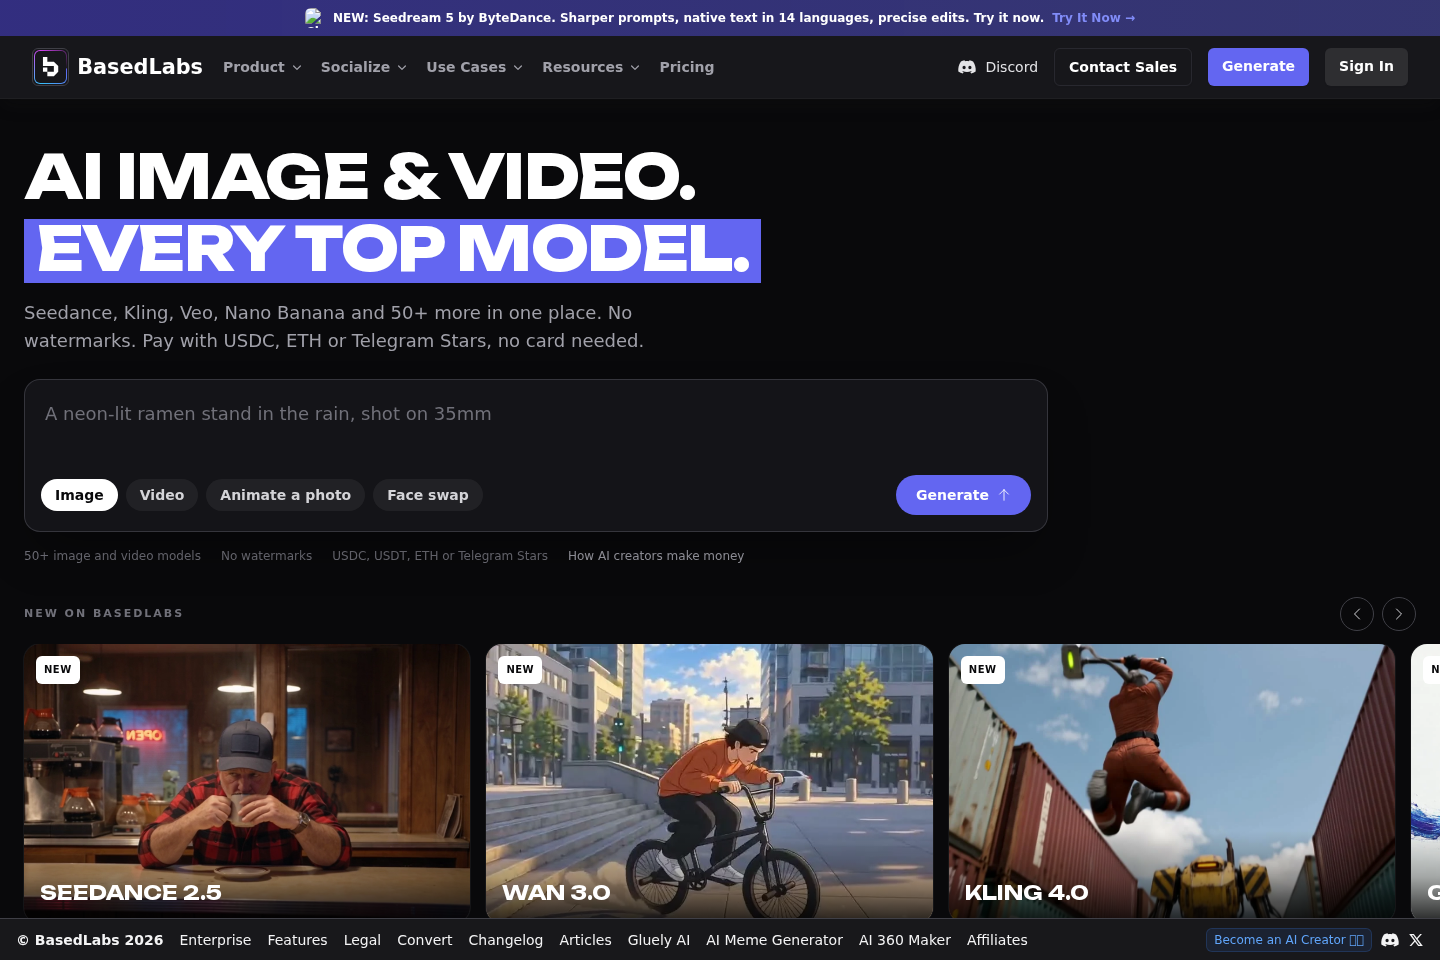
原站网页截图,页面可能随时间更新。
- 分类:AI 视频
- 名称:BasedLabs.ai - AI Image & Video Generator
- 来源:www.basedlabs.ai
BasedLabs.ai 是一个集中使用多种 AI 图像与视频模型的创作平台。用户可以从文字描述或照片出发,生成视觉内容,也可以围绕角色、动作、口播和图像编辑等具体任务选择工具。
平台定位与主要功能
平台将多种图像和视频模型集中在同一账户中,创作入口覆盖图片生成、视频生成、照片动画和人脸替换。部分模型支持从文字生成内容,部分模型支持以照片作为输入;视频相关能力还包括让静态照片执行动作、生成带声音的视频,以及将视频中的动作转移到图片人物上。
适合处理的创作任务
如果目标是快速形成视觉概念,可以从文字描述开始生成图片或视频;如果已有角色照片,可以尝试让照片行走、跳舞或说话。动作控制适合把参考视频中的动作复制到图片人物上,口播头像适合将脚本与面部动作结合。人脸替换可用于将人物面孔置于其他图片中,图像放大则适合改善图片清晰度。
模型选择思路
平台提供超过50种图像和视频模型,模型之间的输入形式、时长、分辨率和声音能力并不相同。选择时可以先按任务区分:文字生成视频、图片生成与编辑、照片转视频,或需要声音的视频,再查看对应模型支持的输入与输出范围。例如,部分视频模型支持最长30秒并带声音,部分图像模型支持最高4K图片或编辑,具体效果应以实际选项为准。
建议的使用流程
可以先明确内容类型和素材条件,再选择图片或视频入口。如果没有现成素材,可先用文字生成基础图片;如果已有照片,则可继续进行动画、动作控制或人脸替换。需要口播时,应准备简洁脚本并选择支持面部说话和唇形同步的工具。完成初稿后,可根据清晰度需求使用图像放大,或重新调整文字描述、参考图片和动作视频。
使用前需要注意的事项
不同模型的生成时长、分辨率、声音和输入方式存在差异,因此不宜把某一模型的能力直接推定到全部模型。平台采用积分方式使用模型,并支持使用USDC、USDT、ETH或Telegram Stars支付;页面列出的示例为300积分10美元。若需要比较成本,建议先确认具体模型的消耗规则,再决定生成次数和素材处理方式。
平台支持哪些主要创作方向?
主要包括AI图像生成、AI视频生成、照片动画、动作控制、口播头像、人脸替换和图像放大。
可以用照片生成视频吗?
可以。平台列出的部分视频模型支持以照片作为输入,也提供让照片执行动作或转为动态内容的工具。
平台如何支付?
页面列出的支付方式包括USDC、USDT、ETH和Telegram Stars,并通过积分使用模型。