T
1

Text To Image AllModels:文字生成图像

Text To Image AllModels 是一款面向 AI 绘图的文字生图应用。用户可通过文字描述图像内容,并在界面中选择相应选项,尝试将创意转化为视觉画面。

链接直达

Text To Image AllModels:文字生成图像

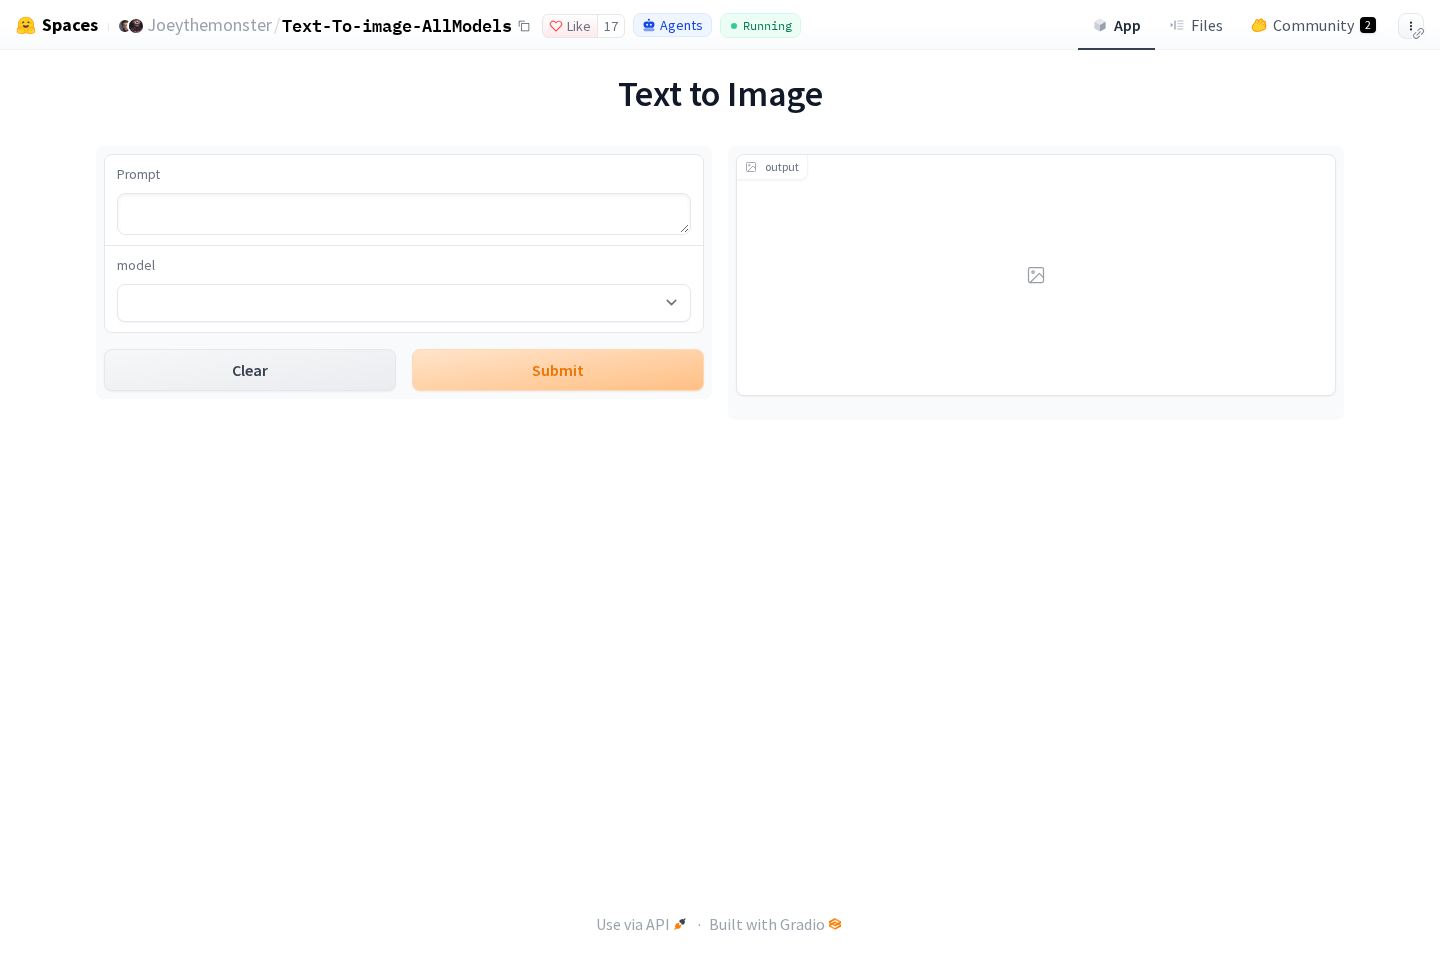
原站网页截图,页面可能随时间更新。

  • 代码许可:openrail
  • 作者:Joeythemonster
  • 分类:AI 绘图
  • 名称:Text To Image AllModels
  • 来源:Hugging Face Spaces

Text To Image AllModels 适合将自然语言中的画面构想转化为图像。使用时,可以先明确主体、场景和风格,再通过文字描述表达需求,并结合界面提供的选择项完成生成设置。

应用定位

这是一款以文字生成图像为核心用途的 AI 绘图应用。它将用户输入的画面描述作为创作入口,适用于从概念构思到视觉草图的表达。

适用任务

当需要把一个场景、物体或创意方向转化为图像时,可以考虑使用这类工具。例如,可用于构思视觉主题、制作创意参考图,或为后续设计提供初步画面方向。具体生成效果取决于输入描述和应用设置。

使用思路

建议先写清楚画面主体,再补充环境、构图、色彩或风格等信息。描述越围绕目标画面组织,越便于表达创作意图;如果结果与预期不同,可以调整文字内容或界面中的选项后再次尝试。

界面操作

应用提供文字生图入口,并包含可供选择的下拉选项。实际使用时,可先输入希望生成的内容,再查看可选设置是否与当前创作目标相符,最后提交生成请求。


访问网站 · 查看资料来源

相关推荐

R

一款基于 SDXL Lightning 的 AI 绘图应用,用于根据文字提示生成图像。界面提供提示词输入、种子和引导强度调节,并通过两步生成模式完成图像创作。

R

Rich Text To Image 是一款 AI 绘图应用,面向需要把带有颜色等富文本属性的文字描述转化为视觉图像的任务。它同时提供普通文本结果、分词分区与标记映射等辅助视图,便于理解文本属性如何参与生成。

O

OCR Image To Text 是一个用于光学字符识别的公开应用。用户可围绕图像输入与文本输出理解其基本用途,适合将图片中的文字整理为可编辑内容,并用于后续的复制、校对或信息处理。

R

Real-Time Latent Consistency Model Text to Image 是一个基于潜在一致性模型的 AI 绘图应用,支持文本生成图像、图像到图像和基于 Canny 的 ControlNet 工作流,并提供结合 LCM-LoRA 的快速推理方案。

B

BiRefNet Demo 是一个基于 Gradio 的图像处理应用,界面公开了图片上传入口,并关联 BiRefNet 与人像分割模型,适合用于需要从图像中分离主体、处理普通图片或人像素材的任务。

评论

暂无评论,来抢沙发~