
Coding News Scrapping:聚合编程与科技资讯的新闻接口
Coding News Scrapping 是一个基于 Flask 与 BeautifulSoup 的轻量级网页抓取 API,可从多个开发者平台获取最新编程和科技文章,并返回标题、来源链接与缩略图,适合用于技术资讯聚合和界面展示。
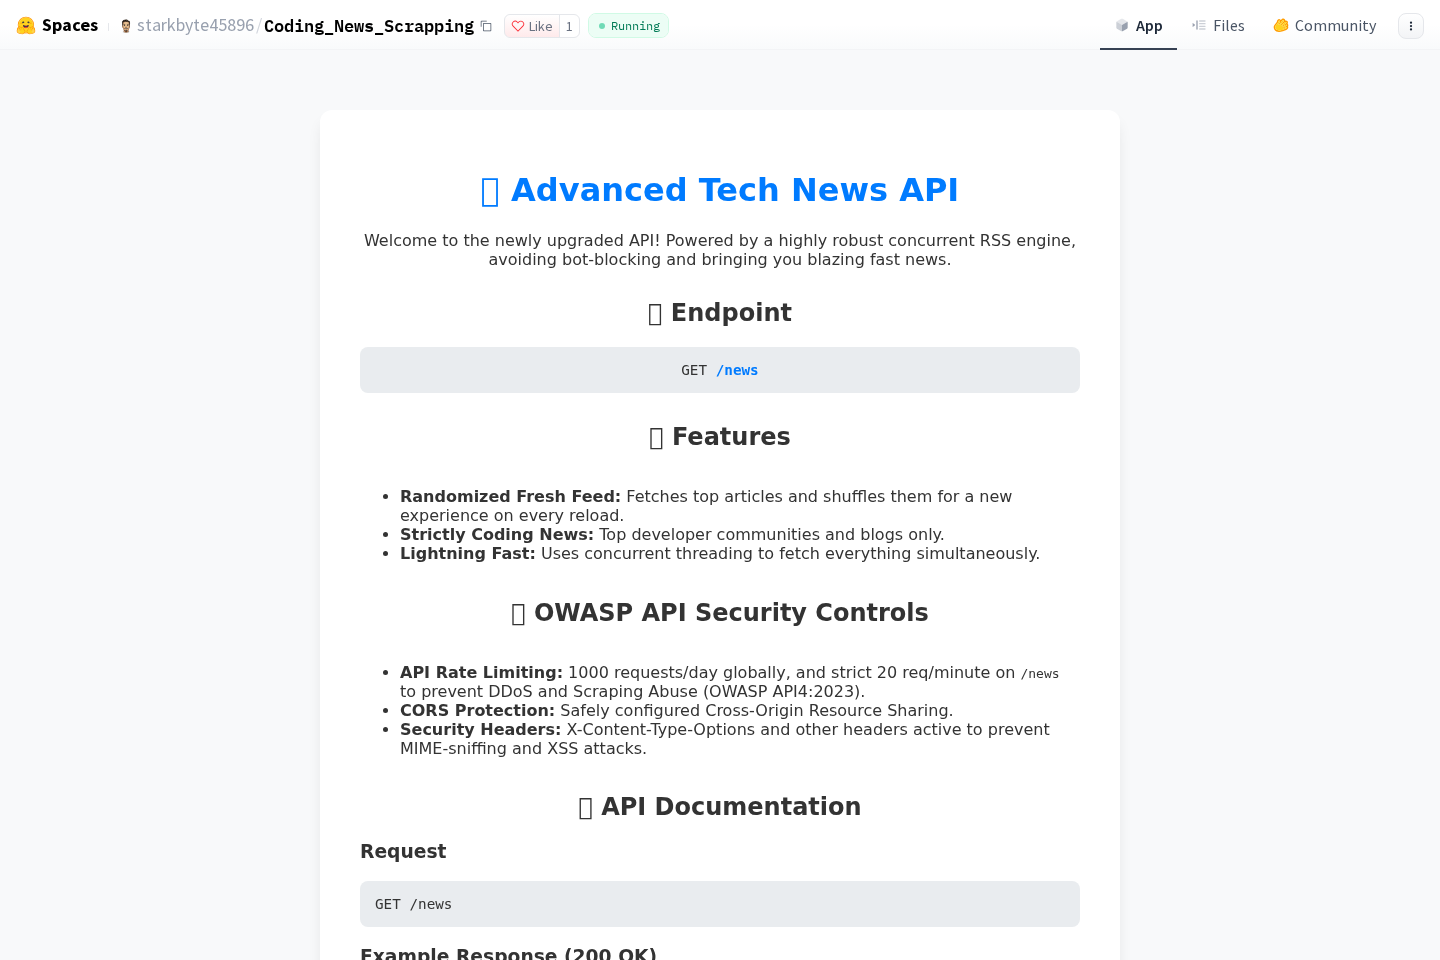
原站网页截图,页面可能随时间更新。
- 作者:starkbyte45896
- 分类:AI 编程与 Agent
- 名称:Coding News Scrapping
- 来源:Hugging Face Spaces
Coding News Scrapping 面向需要集中获取开发领域资讯的开发者或应用,可以把多个技术网站的文章整理为统一的 JSON 数据,减少分别访问和处理不同页面结构的工作。它更适合作为资讯聚合的数据接口,而不是完整的新闻阅读或内容分析系统。
公开功能与返回内容
该应用通过 GET /news 接口提供最新技术文章数据,返回结果为 JSON 数组。每篇文章包含标题、文章链接、缩略图和来源等字段,便于接入网页、卡片布局或瀑布流界面。其抓取方式基于 requests 和 BeautifulSoup,对网页 HTML 进行解析,整体定位是快速、轻量的资讯获取服务。
覆盖的资讯来源
应用聚合了多个编程与科技平台,包括 InfoQ、Hackernoon、Medium 的 Programming 标签、DZone、FreeCodeCamp、CSS-Tricks、SitePoint、Android Dev Blog、Google AI Blog、GitHub Blog、Smashing Magazine 和 The New Stack。来源范围横跨软件开发、前端、移动开发、人工智能及开发者社区内容,适合希望集中浏览多类技术动态的场景。
适用任务与使用思路
如果需要为技术门户、开发者工具或内部资讯面板提供文章数据,可以调用该接口并根据标题、来源和图片字段设计展示页面。缩略图适合用于新闻卡片,来源字段可用于筛选或分组,文章链接则可引导用户阅读原文。对于只关心某一技术方向的应用,建议在接收数据后按来源或内容规则进一步筛选;是否需要缓存、去重和异常处理,应根据具体使用频率与页面需求决定。
本地运行方式
本地部署需要先取得项目代码,安装 requirements.txt 中列出的依赖,然后运行 Web_scrapper.py 启动 Flask API。运行前可按需要在该文件底部设置端口,启动后通过本机地址访问 /news 接口。由于服务依赖目标网站的页面内容,实际使用时应结合来源网站的访问条件和页面变化维护抓取逻辑。
接口返回的主要数据有哪些?
每篇文章主要包含标题、来源链接、缩略图和来源名称,整体以 JSON 数组形式返回。
它适合直接作为新闻阅读器吗?
它主要提供聚合后的文章数据和链接,更适合作为新闻阅读界面或资讯面板的数据接口。
本地启动时可以修改端口吗?
可以按需要在 Web_scrapper.py 文件底部设置偏好的端口后再运行服务。