
T
1
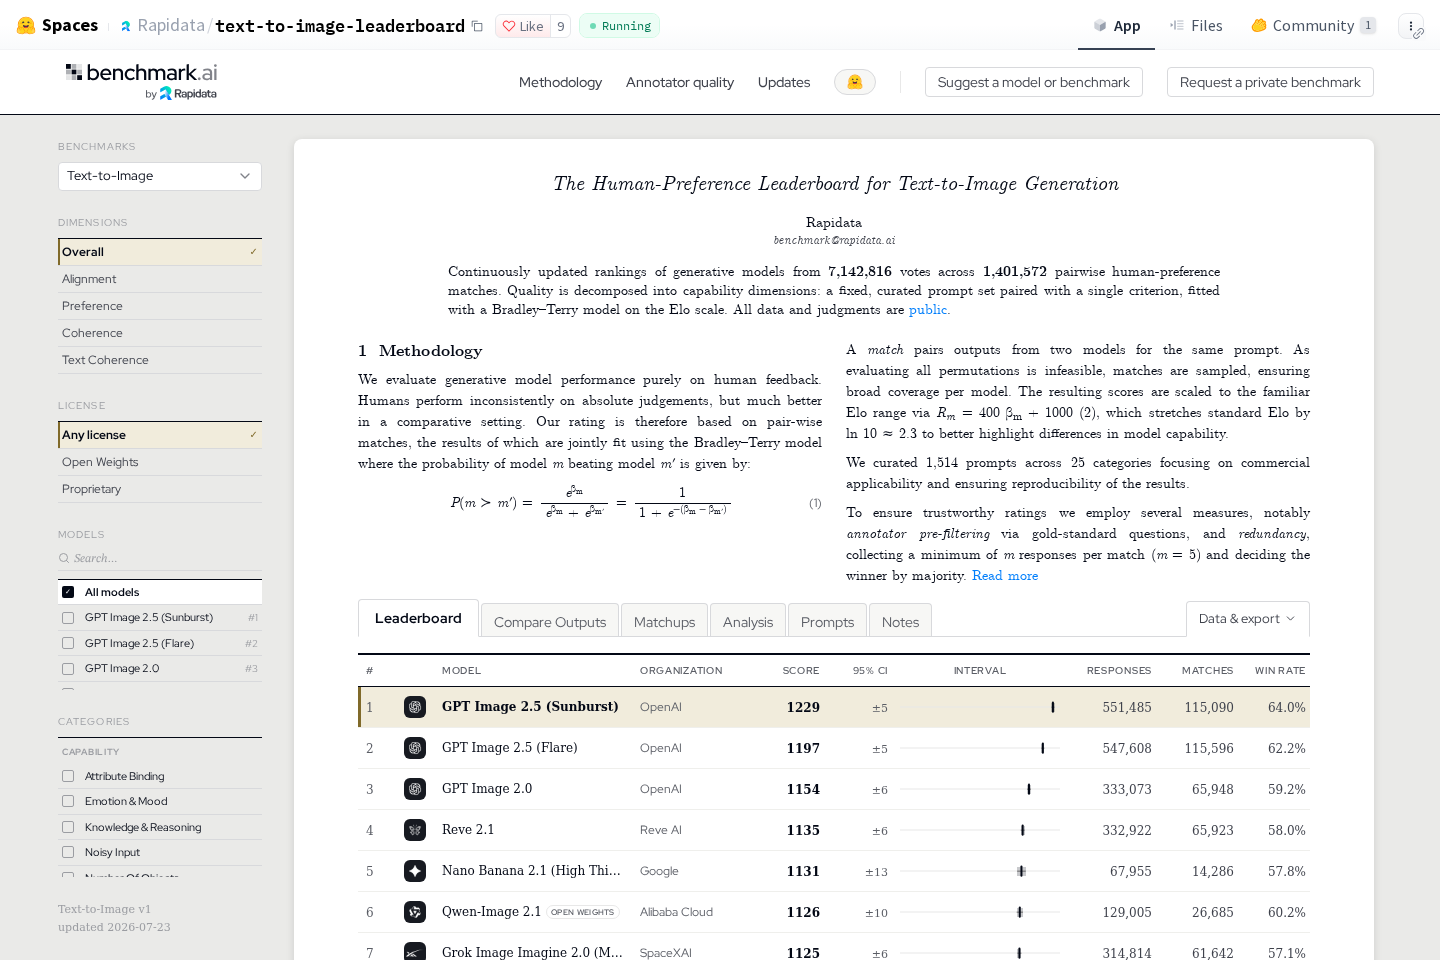
原站网页截图,页面可能随时间更新。
- 作者:Rapidata
- 分类:AI 绘图
- 名称:Text to Image Benchmark
- 来源:Hugging Face Spaces
Text to Image Benchmark 聚焦文本生成图像模型的横向比较。它将真实用户对图像结果的选择整理为排名,并从整体偏好、画面连贯性和提示词契合度等角度提供参考,帮助使用者更有针对性地了解不同模型的相对表现。
公开功能
该工具公开呈现文本生成图像模型的排行榜,排名依据来自真实用户投票。评价关注三个方面:用户对结果的整体偏好、图像内容是否连贯,以及生成结果与提示词要求的契合程度。
适用任务
它适合用于模型选型前的初步比较,例如需要从多个文本生成图像模型中缩小范围时,参考不同模型在整体观感、画面一致性和提示词响应方面的相对位置。对于重视用户观感或提示词执行效果的图像生成任务,排名可作为比较维度之一。
使用思路
使用时可以先明确任务更看重哪类结果:如果关注整体视觉接受度,可优先观察整体偏好排名;如果画面容易出现结构混乱,则应留意连贯性维度;如果需求依赖对文字描述的准确执行,则可重点参考提示词契合度。综合这些维度后,再结合具体创作目标选择候选模型。
如何理解排名
排行榜反映的是基于用户投票形成的偏好结果,适合用于相对比较,不应直接视为所有场景下的绝对结论。实际选择时,还应将任务主题、提示词写法和期望的图像风格纳入判断,并针对候选模型进行进一步比较。
常见问题
排名主要依据什么?
排名依据真实用户投票,评价涉及整体偏好、画面连贯性和提示词契合度。
这个工具适合解决什么问题?
它适合帮助使用者比较文本生成图像模型,并在模型选型时提供参考。