
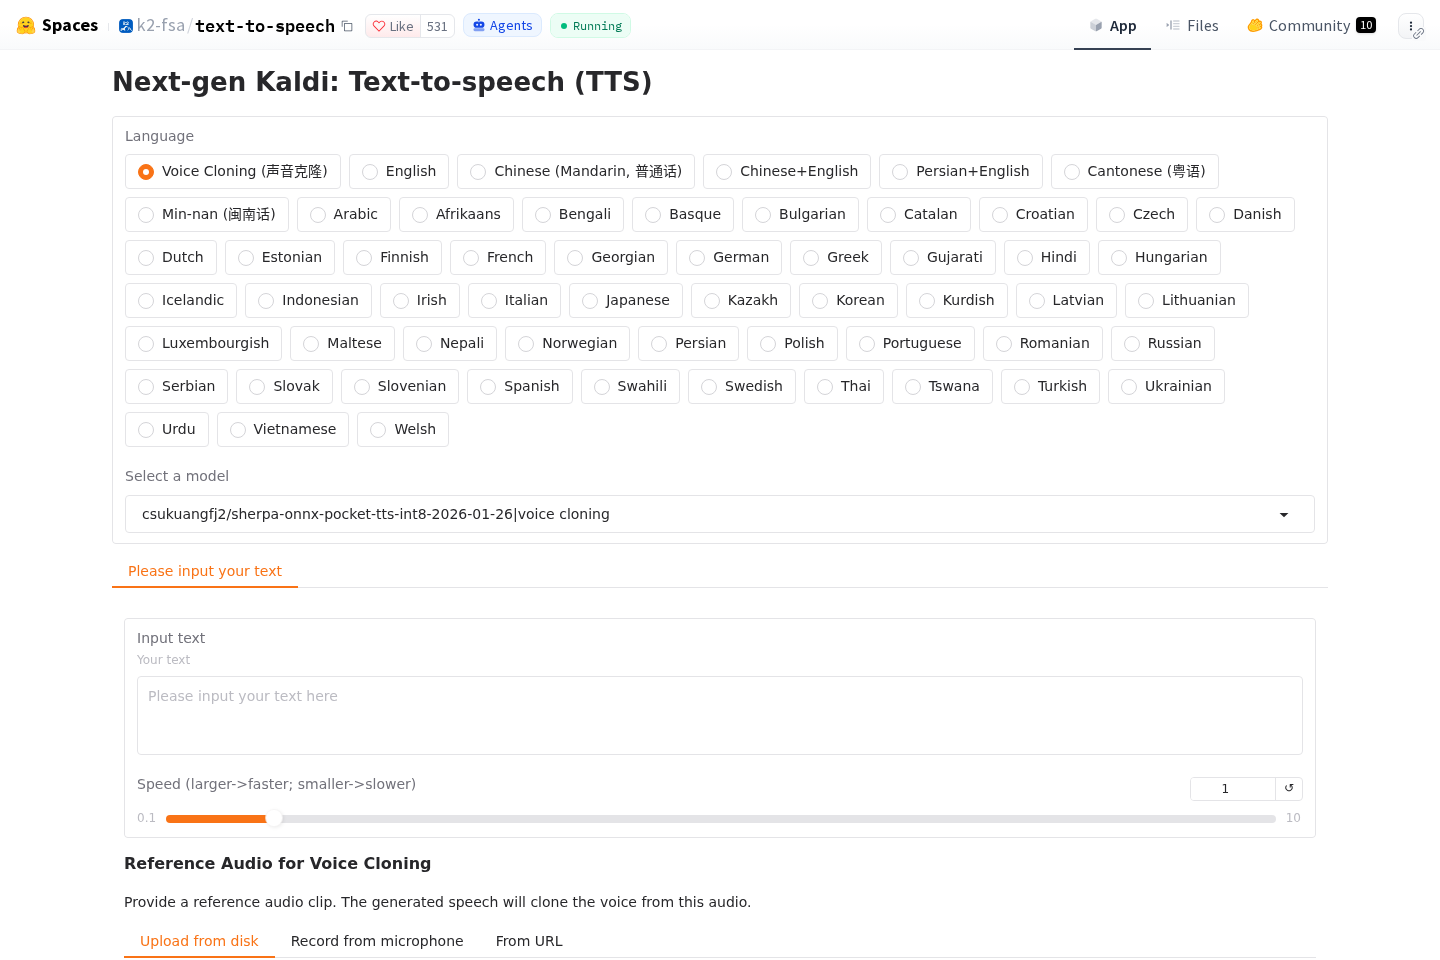
目标网站网页截图,页面可能随时间更新。
- 代码许可:apache-2.0
- 作者:k2-fsa
- 分类:AI 音频
- 名称:tts Text To Speech
- 来源:Hugging Face Spaces
tts Text To Speech 面向需要把文字转成音频的场景,提供从文本输入、模型选择到音频输出的一体化界面。对于需要保持特定声音特征的任务,还可以结合参考音频使用相关功能。
主要功能
应用提供模型选择、文本输入、语速调节和音频输出等组件。用户可以在文本框中输入待合成内容,并通过 Speed 滑块调整语速:数值较大时语速更快,数值较小时语速更慢。生成结果会以音频形式输出。
- 选择可用模型
- 输入待转换文本
- 调节语音速度
- 获取输出音频
它主要用于什么?
主要用于将输入文本转换为语音,并输出音频结果。
参考音频与声音克隆
界面包含 Reference Audio for Voice Cloning 区域,可提供参考音频,并说明生成语音将克隆该音频中的声音。参考音频可以通过上传、录音或音频文件地址获取,下载后的参考音频也会显示在界面中。
- 上传参考音频
- 直接录制参考音频
- 提供参考音频地址
- 查看已获取的参考音频
参考音频有什么作用?
参考音频用于声音克隆相关处理,生成语音会以该音频中的声音为参考。
参考文本的使用
界面提供 Reference Text 输入框,用于填写参考音频中实际说出的文字。对于 ZipVoice,该文本为必填项,并且必须与参考音频中的语音内容完全一致。因此,使用这类模型时,应先确认参考音频内容,再准确输入对应文字。
- 确认参考音频中的完整话语
- 按原内容填写参考文本
- 使用 ZipVoice 时保持文字与音频完全一致
参考文本是否总是必填?
界面说明中明确指出,参考文本在 ZipVoice 中为必填,并且必须与参考音频实际说出的内容完全一致。
适用任务与操作思路
它适合需要把文字制作成语音文件的任务,也适合需要以一段参考音频作为声音依据的场景。较稳妥的操作顺序是先选择模型,再输入文本并调节语速;如果需要声音克隆,则准备参考音频,并在使用 ZipVoice 时补充完全匹配的参考文本,最后获取音频输出。
- 文本转语音
- 语速调整
- 基于参考音频的声音克隆处理
- 多说话人模型下的说话人选择
- 选择模型并填写文本。
- 根据需要调整 Speed。
- 需要参考声音时,上传、录制或提供参考音频。
- 若使用 ZipVoice,填写与参考音频完全一致的 Reference Text。
- 提交处理并查看音频输出。
多说话人模型如何指定说话人?
界面提供 Speaker ID 输入项;该项仅对多说话人模型有效。
使用时的注意事项
Speaker ID 并非所有模型都适用,只有在多说话人模型下才有意义。参考文本也应严格对应参考音频中的实际内容,尤其是在 ZipVoice 场景中。语速调整可以改变播放速度方向,但具体效果仍取决于所选模型和输入内容。
- 先确认所选模型是否支持多说话人设置
- 使用参考文本时保持内容精确匹配
- 根据听感需要调整语速
可以通过哪些方式提供参考音频?
可以上传参考音频、录制参考音频,或提供参考音频文件地址。