
T
2
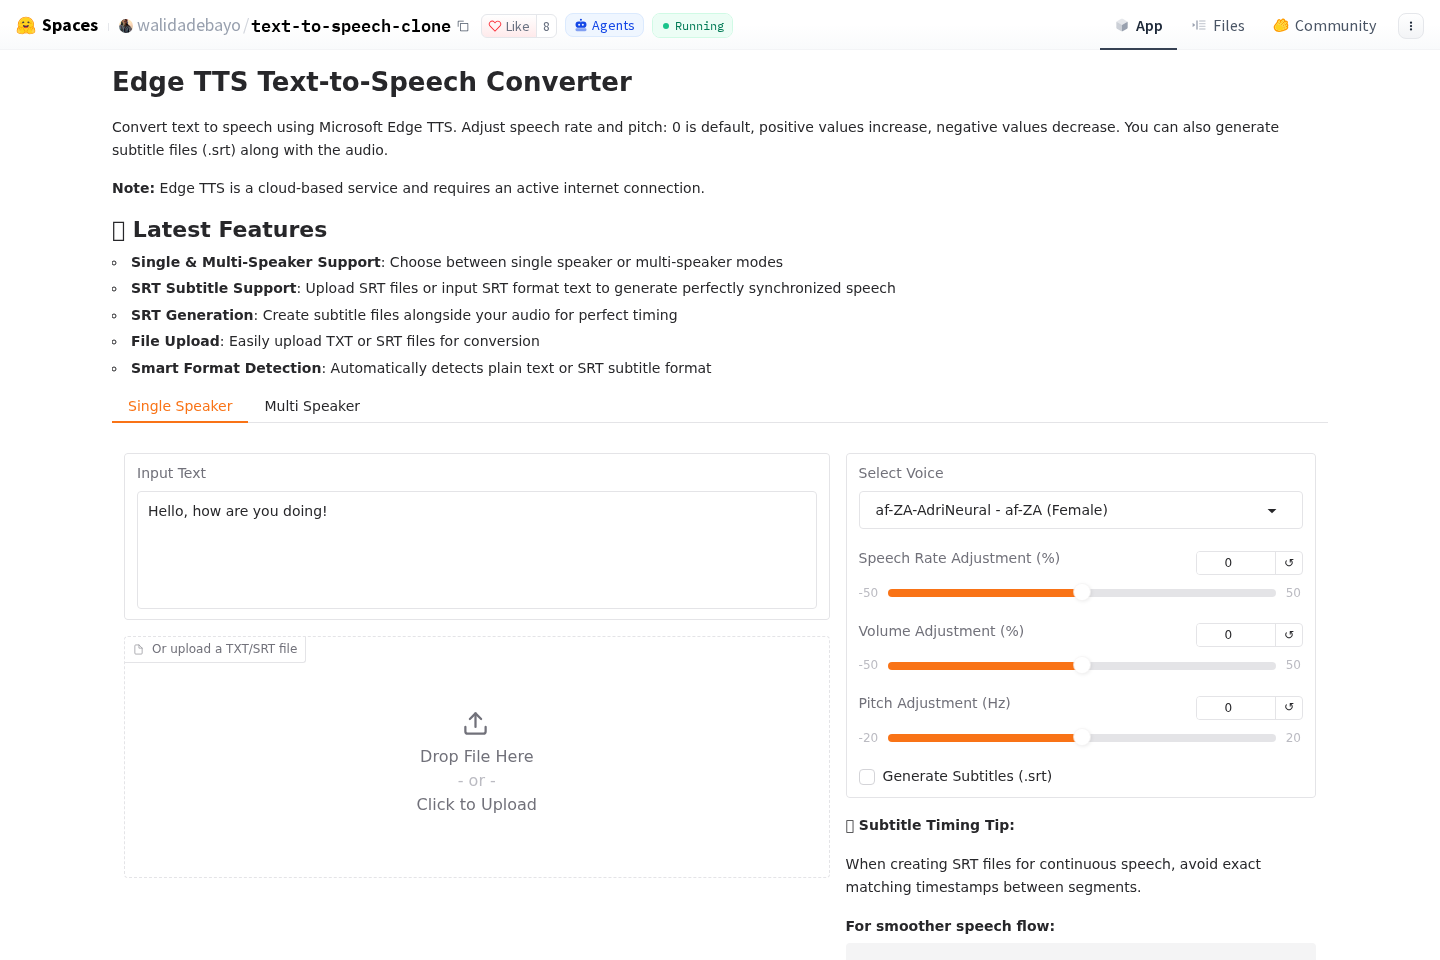
原站网页截图,页面可能随时间更新。
- 代码许可:mit
- 作者:walidadebayo
- 分类:AI 音频
- 名称:Text To Speech
- 来源:Hugging Face Spaces
这款工具适合把文字内容整理成可播放的语音,也可用于带有时间轴的字幕文本处理。使用时可直接输入内容,或上传 TXT、SRT 文件,再选择声音并调整语速、音量和音高;对话场景则可分别设置不同说话人的声音参数。
主要用途
工具面向文字转语音任务,输出生成的音频,并提供生成字幕文件。输入方式包括直接填写文字,以及上传 TXT 或 SRT 文件。对于连续朗读内容,SRT 文件中的时间段会影响语音衔接效果。
单人内容的使用思路
处理普通旁白、说明文本或单一说话人内容时,可以先在输入区域填写文字,或导入已有文本文件,然后选择语音。语速、音量和音高分别用于调整朗读节奏、声音响度和音调,建议根据内容长度与听感需要逐项调整。
多角色对话处理
多说话人文本需要按照“Speaker1: text”或“S1: text”的格式标记角色。工具提供两名说话人的独立声音选择,以及各自的语速、音量和音高设置,因此适合区分对话中的不同角色。实际整理文本时,应保持角色标记清楚,并让每段内容对应正确的说话人。
字幕时间轴注意事项
连续语音对应的 SRT 片段不宜让前一段结束时间与后一段开始时间完全相同。可以在相邻片段之间设置约 20 至 30 毫秒的小幅重叠,以减少不必要的停顿;如果确实需要停顿,则可以保留时间上的间隔。
SRT 字幕片段为什么要设置轻微重叠?
在连续语音中,约 20 至 30 毫秒的时间重叠有助于减少片段之间的停顿,使语音衔接更顺畅。
什么时候可以避免字幕时间重叠?
如果内容需要明确停顿,可以不设置重叠;同时应避免让前一段结束时间与后一段开始时间完全相同。