
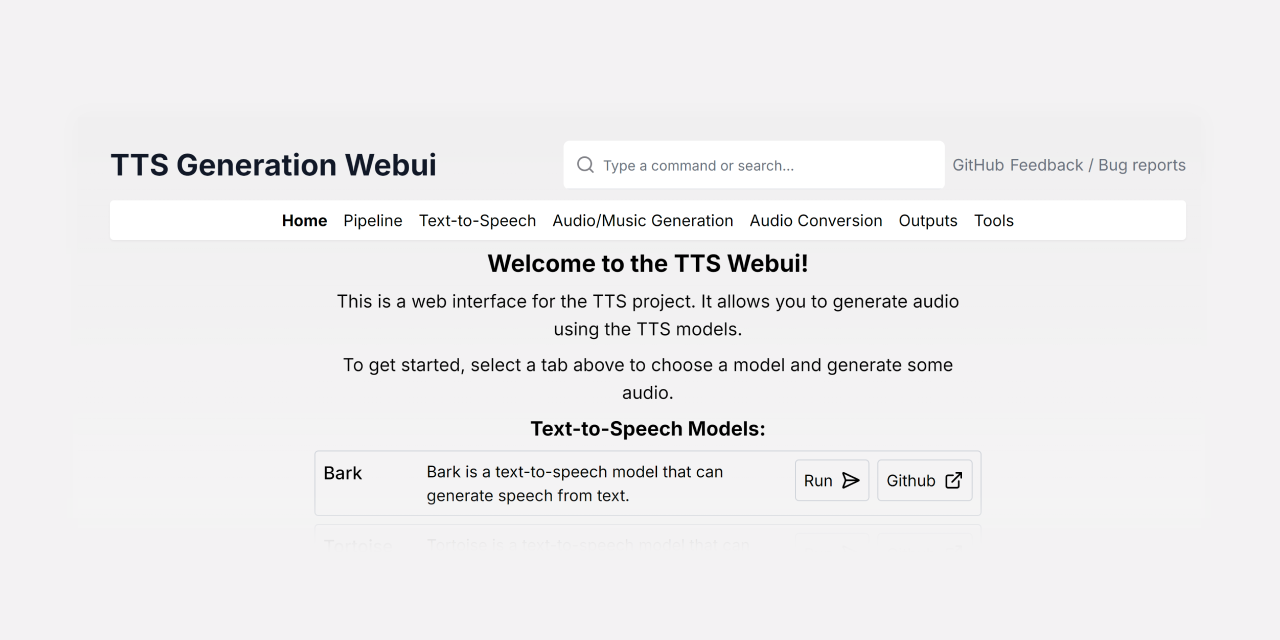
原站提供的展示图片。
- 分类:AI 音频
- 名称:GitHub - rsxdalv/TTS-WebUI: A single Gradio + React WebUI with extensions for ACE-Step, OmniVoice, Kimi Audio, Piper TTS, GPT-SoVITS, CosyVoice, XTTSv2, DIA, Kokoro, OpenVoice, ParlerTTS, Stable Audio, MMS, StyleTTS2, MAGNet, AudioGen, MusicGen, Tortoise, RVC, Vocos, Demucs, SeamlessM4T, and Bark!
- 来源:github.com
TTS WebUI 将多类音频模型集中到同一个操作界面中,适合需要在本地尝试不同语音、音乐和音频处理方案的用户。它提供基础模型与可选扩展,用户可以根据任务安装相应能力,再通过统一入口生成或处理音频。
功能范围
工具覆盖文字转语音、音乐与音频生成、声音转换、音频分离、降噪、增强和语音识别等方向。支持的模型包括 Bark、Tortoise、XTTSv2、GPT-SoVITS、CosyVoice、Kokoro、OpenVoice、Piper TTS、MusicGen、Stable Audio、RVC、Demucs、Vocos、Whisper 和 SeamlessM4T 等。部分模型以扩展形式提供,不会随基础安装默认配置。
适用任务
在文字转语音场景中,可以用它把文本转换为语音;在音乐和音效创作中,可以尝试 MusicGen、Stable Audio 等生成模型;需要改变声音表现时,可以使用声音转换能力;处理已有音频时,则可结合分离、降噪、增强或编解码相关工具。不同模型的用途和依赖不同,实际选择应根据任务类型和本机资源决定。
使用思路
使用时可先完成基础环境安装,再启动界面并选择需要的模型。若目标模型属于扩展,应通过界面或扩展管理工具安装,安装或更新后重启应用以加载变化。一个稳妥的流程是先明确任务属于语音、音乐、转换还是音频处理,再只安装对应模型,随后输入文本或音频并调整模型提供的参数,最后从输出目录查看生成结果。
部署与资源
项目支持安装器、手动安装和 Docker 部署。手动方式需要 Git、Python 3.10 或 3.11、PyTorch 与带 Vorbis 支持的 ffmpeg,React 界面还可使用 Node.js。基础安装约占 10.7 GB,每个模型还可能额外需要 2—8 GB 空间;模型组合较多时,依赖之间可能出现版本兼容提示,项目说明将这类提示视为多项目整合环境中的常见情况。
扩展与连接
扩展本质上是通过 pip 安装的 Python 包,可以同时安装多个扩展,但不同项目之间可能存在兼容性问题。工具还提供 OpenAI 兼容 API,可用于连接 SillyTavern、OpenWebUI 或其他兼容客户端;这类连接需要先启用相应 API 扩展并启动服务。使用声音或人物相关能力时,应遵守法律、隐私和知识产权要求,不得用于冒充、欺诈或其他有害用途。