
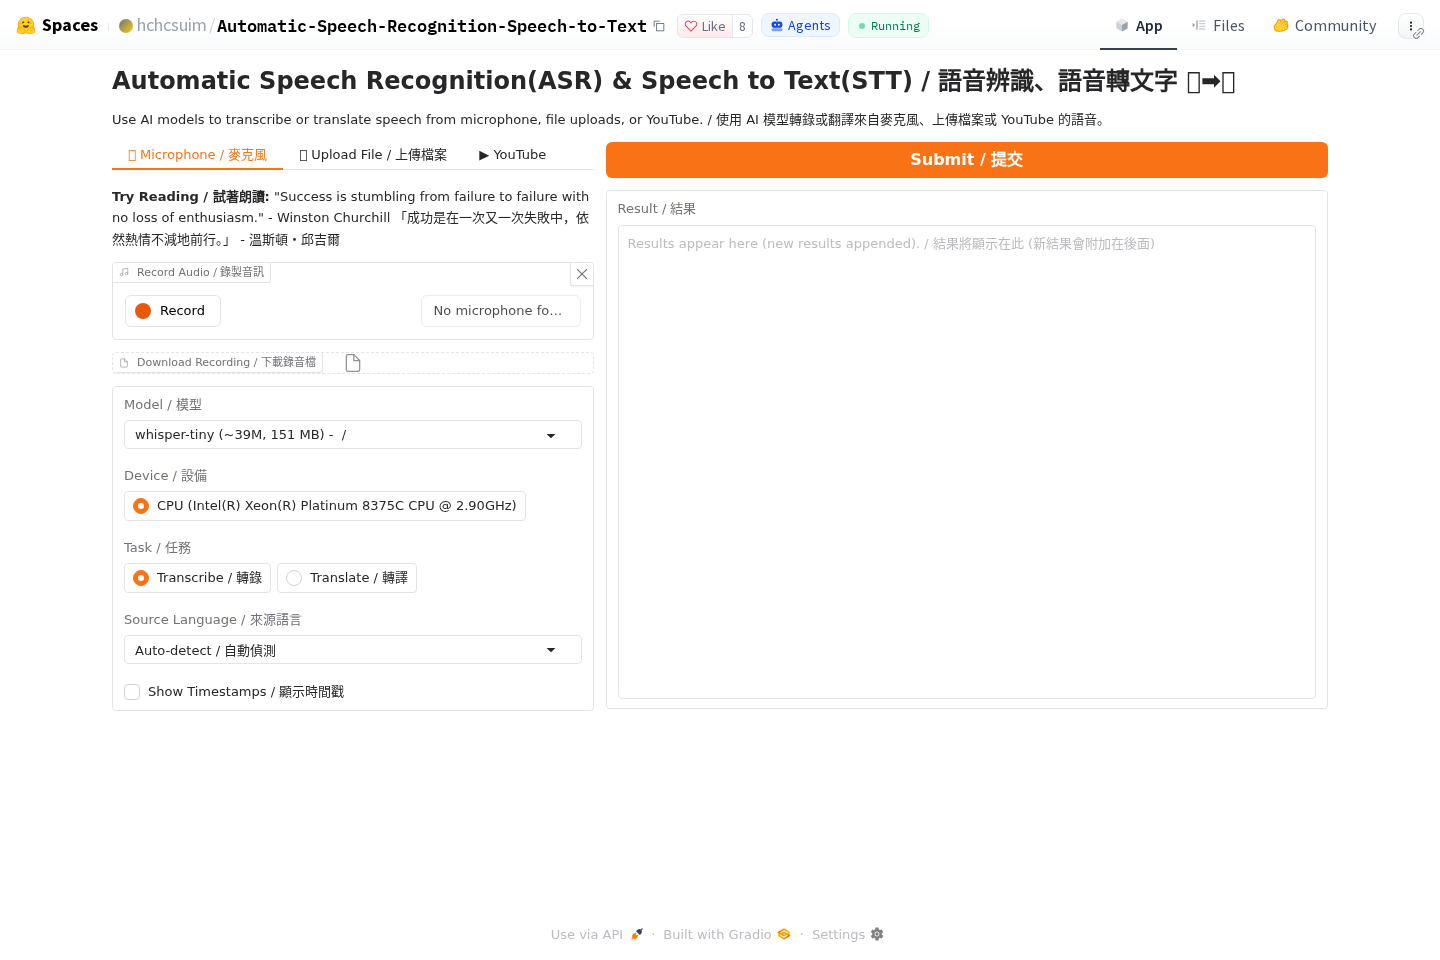
原站网页截图,页面可能随时间更新。
- 代码许可:apache-2.0
- 作者:hchcsuim
- 分类:AI 音频
- 名称:Automatic Speech Recognition Speech To Text
- 来源:Hugging Face Spaces
Automatic Speech Recognition Speech To Text 面向需要把语音内容转换为文字的场景,支持录制音频、上传音频文件和处理 YouTube 音频。使用时可选择模型与来源语言,部分模型还可填写转录提示词,随后在结果区域查看生成内容。
核心功能
应用围绕语音转文字与语音翻译展开。用户可以直接录制音频,也可以上传已有音频文件,并在处理前预览音频内容。完成转录后,结果会显示在专用区域,新结果会追加到已有内容之后,便于连续处理多段录音。
适用任务
它适合将会议片段、访谈录音、课程内容或其他语音素材整理成文字,也可用于需要把语音内容转换为另一种语言表达的任务。若语音来源是 YouTube,可粘贴视频链接并尝试获取对应音频,再进行后续处理。
使用思路
开始前可根据任务选择模型,并设置来源语言。对于提供专用提示词输入的模型,可在相应区域写明希望执行的操作,例如要求将音频转录为文字。处理本地素材时,可以先录音或上传文件,确认音频预览无误后再提交;若使用链接,则先粘贴 YouTube 地址并获取音频。
本地运行条件
如果需要在电脑上部署,可准备 Python 3.10,并创建和启用 Python 虚拟环境,再安装项目所需依赖。Windows 环境还需要安装 ffmpeg 并将其加入系统路径。运行前可以检查 PyTorch 是否识别 CUDA;若识别到 CUDA,还能查看当前检测到的 GPU 名称。
使用限制
YouTube 音频下载受运行环境影响。在 Hugging Face Spaces 中,该功能因安全限制无法通过 YouTube 的机器人验证;如果要使用这项能力,应考虑在本地环境运行应用。直接录音或上传音频则对应应用提供的本地音频输入方式。
在 Hugging Face Spaces 中可以下载 YouTube 音频吗?
不可以。该运行环境无法通过 YouTube 的机器人验证,YouTube 下载功能应在本地环境中使用。
应用支持哪些音频输入方式?
可以通过麦克风录制、上传音频文件,或在支持的本地运行环境中使用 YouTube 链接获取音频。