
T
1
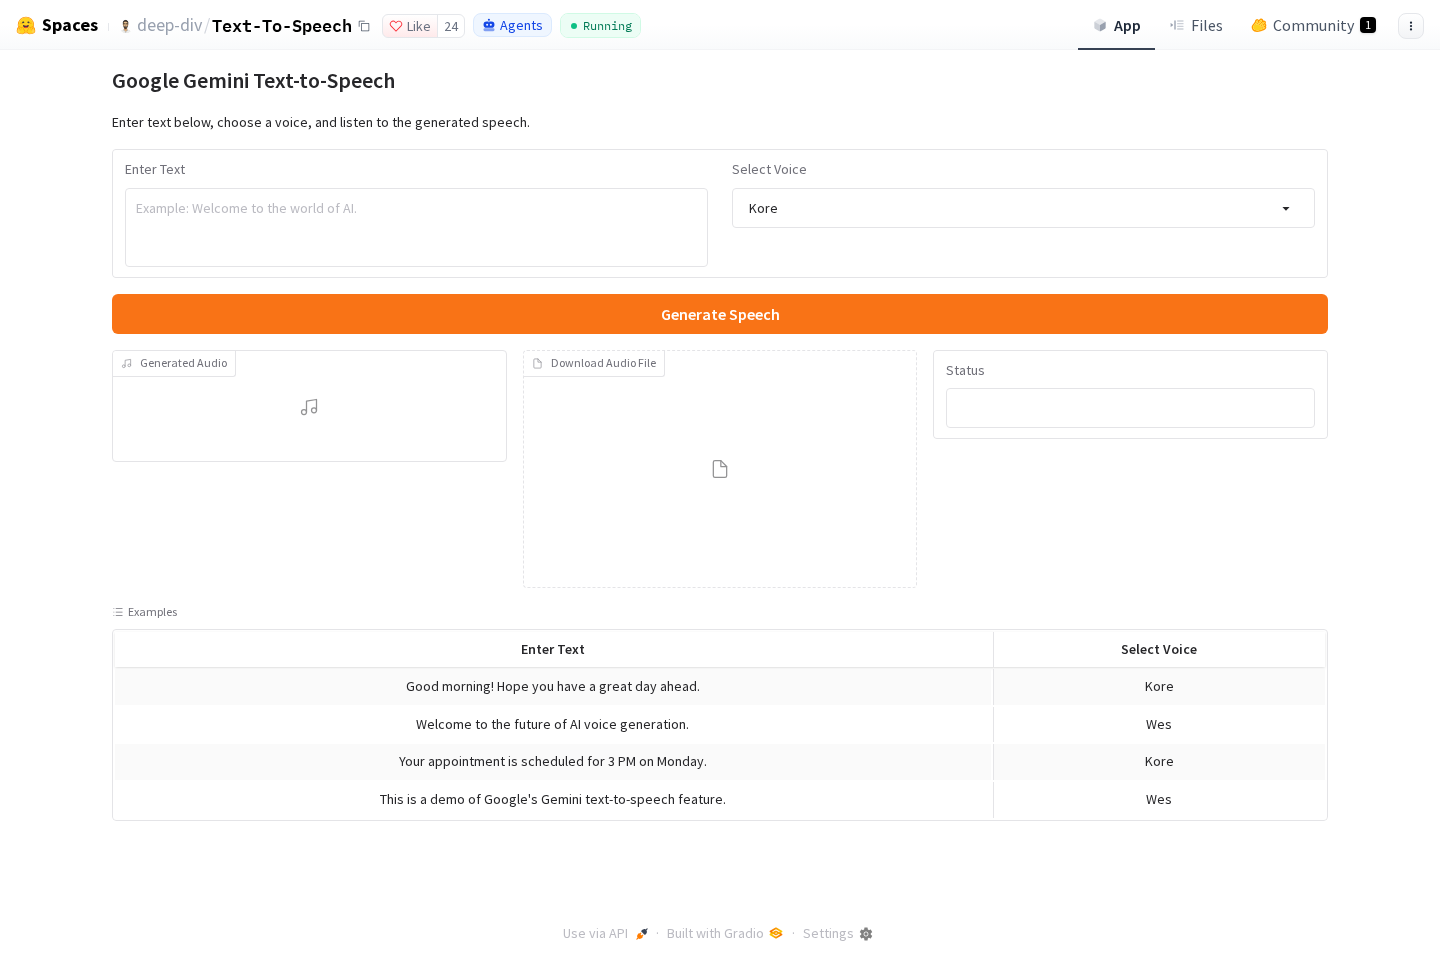
目标网站网页截图,页面可能随时间更新。
- 代码许可:apache-2.0
- 作者:deep-div
- 分类:AI 音频
- 名称:Text To Speech
- 来源:Hugging Face Spaces
Text To Speech 面向需要把文字内容转换为语音的场景。用户可以输入一段文本,选择声音选项,生成音频并进行播放;完成后还可以下载生成的音频文件,用于后续整理或使用。
公开功能
应用界面提供文本输入框、声音选择下拉菜单、生成操作按钮、生成音频播放器、音频文件下载入口和状态文本区域。输入文本后,可通过声音选项参与语音生成流程,并在结果区域试听音频。
- 输入待转换的文字
- 选择语音选项
- 播放生成的音频
- 下载音频文件
适用任务
它适合处理需要将书面文字转为可听内容的任务,例如把简短说明、提示语或其他文本整理成语音素材。对于希望先试听再保存结果的工作流程,应用提供了从输入到播放、下载的连续操作路径。
使用思路
使用时可以先准备结构清楚、长度适中的文本,再选择合适的声音选项并提交生成。生成后先通过播放器检查语音内容是否符合预期;如果需要保留结果,可使用下载功能保存音频文件。对于较长内容,若界面处理不便,可以考虑分段输入并分别生成。
- 准备需要转换的文字
- 将文字输入文本框
- 在声音菜单中选择选项
- 提交生成并播放音频
- 需要保存时下载音频文件
常见问题
这个应用可以做什么?
它用于将用户输入的文字转换为语音,并提供生成音频的播放与下载功能。
使用时需要输入什么?
需要在文本输入框中填写希望转换成语音的文字。
生成后能否试听?
可以,生成结果会显示为音频播放器,可用于播放生成的语音。
能否保存生成结果?
界面提供音频文件下载入口,可以在生成音频后下载文件。