
X
1
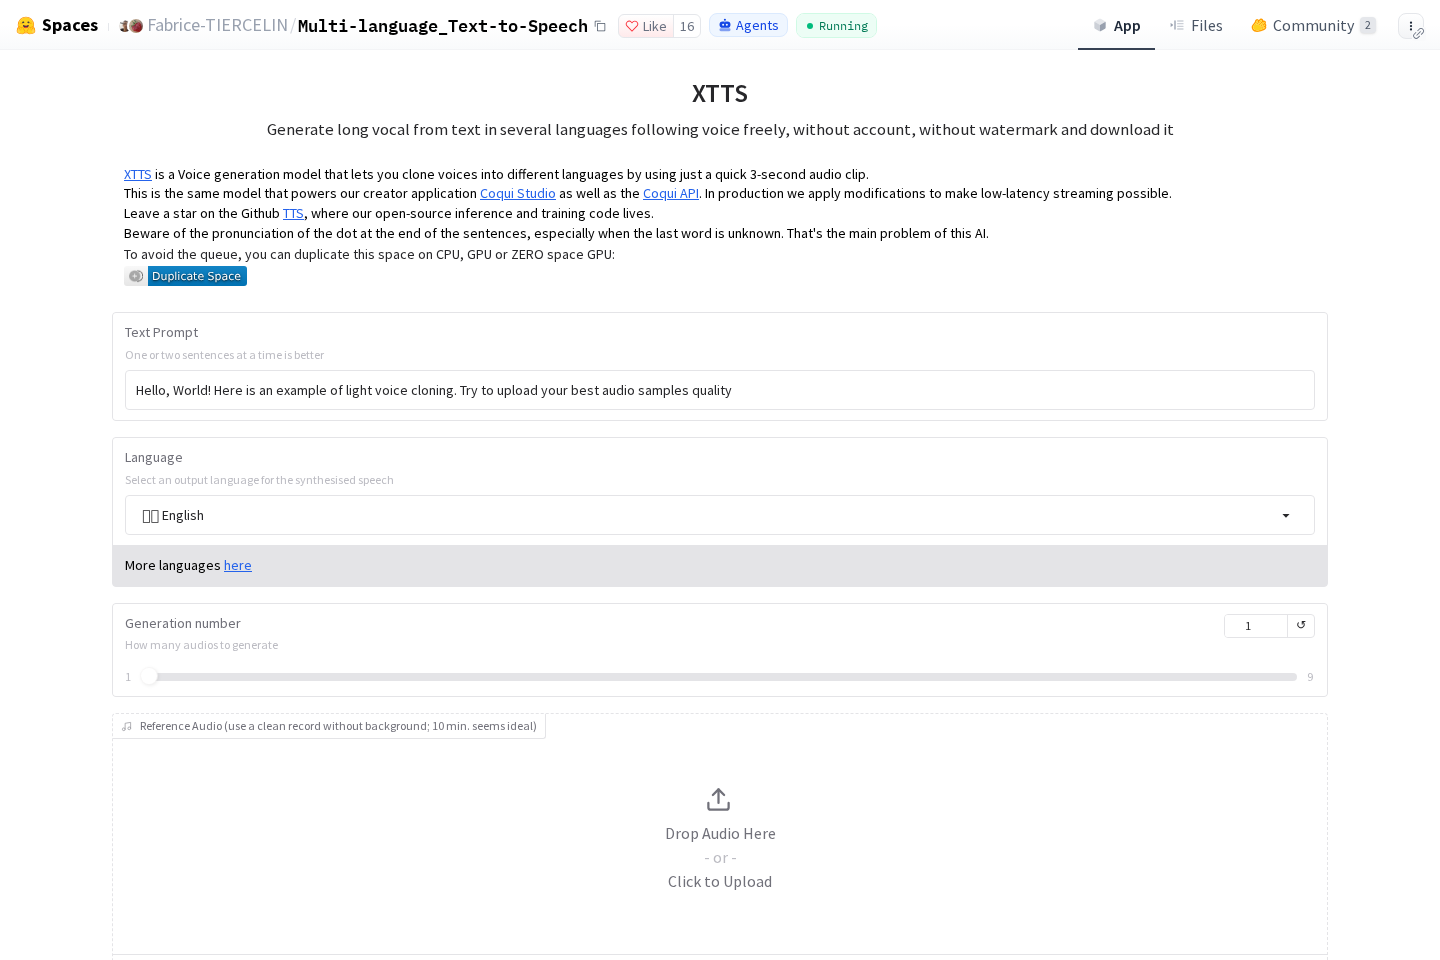
原站网页截图,页面可能随时间更新。
- 作者:Fabrice-TIERCELIN
- 分类:AI 音频
- 名称:XTTS
- 来源:Hugging Face Spaces
XTTS 将文字内容转换为合成语音,并允许通过参考音频为生成过程提供声音样本。它适合需要把短文本快速转成语音、比较多种生成结果,或尝试不同语言输出的任务。
公开功能
应用提供文本输入、参考音频输入和输出语言选择。参考音频可以通过上传录音或麦克风录制获得,生成结果以多条音频形式呈现,便于对比不同版本。界面还提供生成数量、温度和随机种子等参数,用于控制输出数量与生成变化。
适用任务
XTTS 可用于将一至两句文字转换为语音,适合制作短提示音、语音草稿、配音片段或多语言语音样例。若任务需要比较同一文本在不同生成设置下的声音差异,可以增加生成数量并并列试听;若需要指定语言,则应先选择对应的输出语言。
使用思路
开始时可输入一至两句文本,并准备一段干净、没有背景声的参考录音。随后选择合成语言,设置希望生成的音频数量,再运行生成。参考音频越适合作为输入,越有利于围绕目标声音进行尝试;录音时可优先保持环境安静、内容清晰。
参数调整
温度参数用于改变生成的稳定程度与变化倾向:较低数值通常更容易得到相近的结果,较高数值则会带来更强的创造性。对于未知语言,可尝试使用0.75;面向母语者的输出,可以尝试将温度设为1.0并生成多个版本。随机种子适合在需要记录或复现某次生成设置时使用。
本地运行
XTTS 也可以安装到本地计算机。使用 Pinokio 安装时,具备 Nvidia GPU 可能更容易完成安装;通过 Docker 安装同样可行,但操作会更复杂。实际选择哪种方式,可根据设备条件和对本地部署流程的熟悉程度决定。
参考音频应该如何准备?
建议使用没有背景声的干净录音;界面说明中提到约10分钟的录音似乎较为理想。
一次输入多少文字更合适?
界面提示一次输入一至两句通常更合适。