
S
1
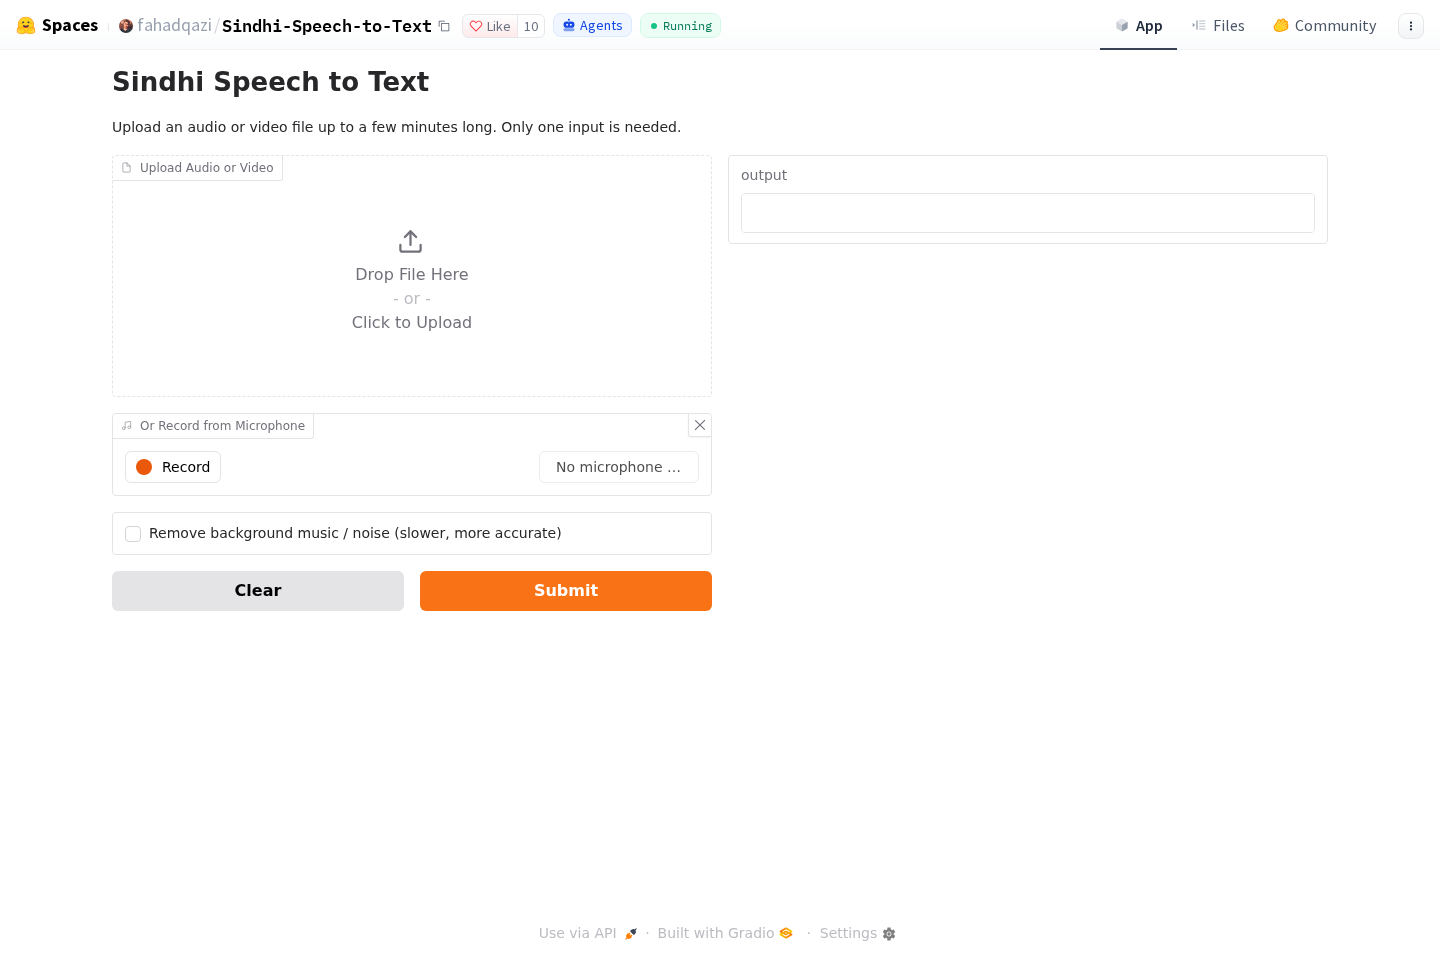
原站网页截图,页面可能随时间更新。
- 代码许可:cc
- 作者:fahadqazi
- 分类:AI 音频
- 名称:Sindhi Speech To Text
- 来源:Hugging Face Spaces
Sindhi Speech To Text 的用途集中在将信德语语音内容转换为文字。使用时只需准备一段音频或视频文件,或直接通过麦克风录音,再提交给应用处理,适合需要把口述内容整理成文本的场景。
公开功能
应用接受音频或视频文件作为输入,也提供麦克风录音方式。一次使用只需要提供一个输入,上传的文件长度适合控制在几分钟以内。其核心任务是进行信德语语音转文字处理。
适用任务
它可以用于整理较短的信德语录音、提取视频中的语音内容,或把现场录音转换为后续编辑所需的文字底稿。对于访谈片段、口述记录和短视频语音等内容,可先完成转写,再根据实际需要进行校对和排版。
使用思路
准备音频或视频时,建议优先选择语音清楚、时长适中的文件;如果内容来自现场,也可以使用麦克风录制。提交后,可将输出文字作为初稿使用,并结合原始录音检查专有词、口音、多人对话和背景噪声造成的识别差异。
识别信息
公开说明给出了10%的词错误率指标,并注明模型使用专有数据训练,训练数据规模为70小时音频与文本配对数据。这些信息可帮助使用者了解其定位,但具体文本质量仍可能随录音清晰度、说话方式和内容类型变化。
常见问题
可以输入哪些内容?
可以上传音频或视频文件,也可以使用麦克风录音。
一次需要提供多个文件吗?
不需要,一次使用只需要一个输入。
文件时长有什么要求?
公开界面说明文件适合控制在几分钟以内。