
T
1
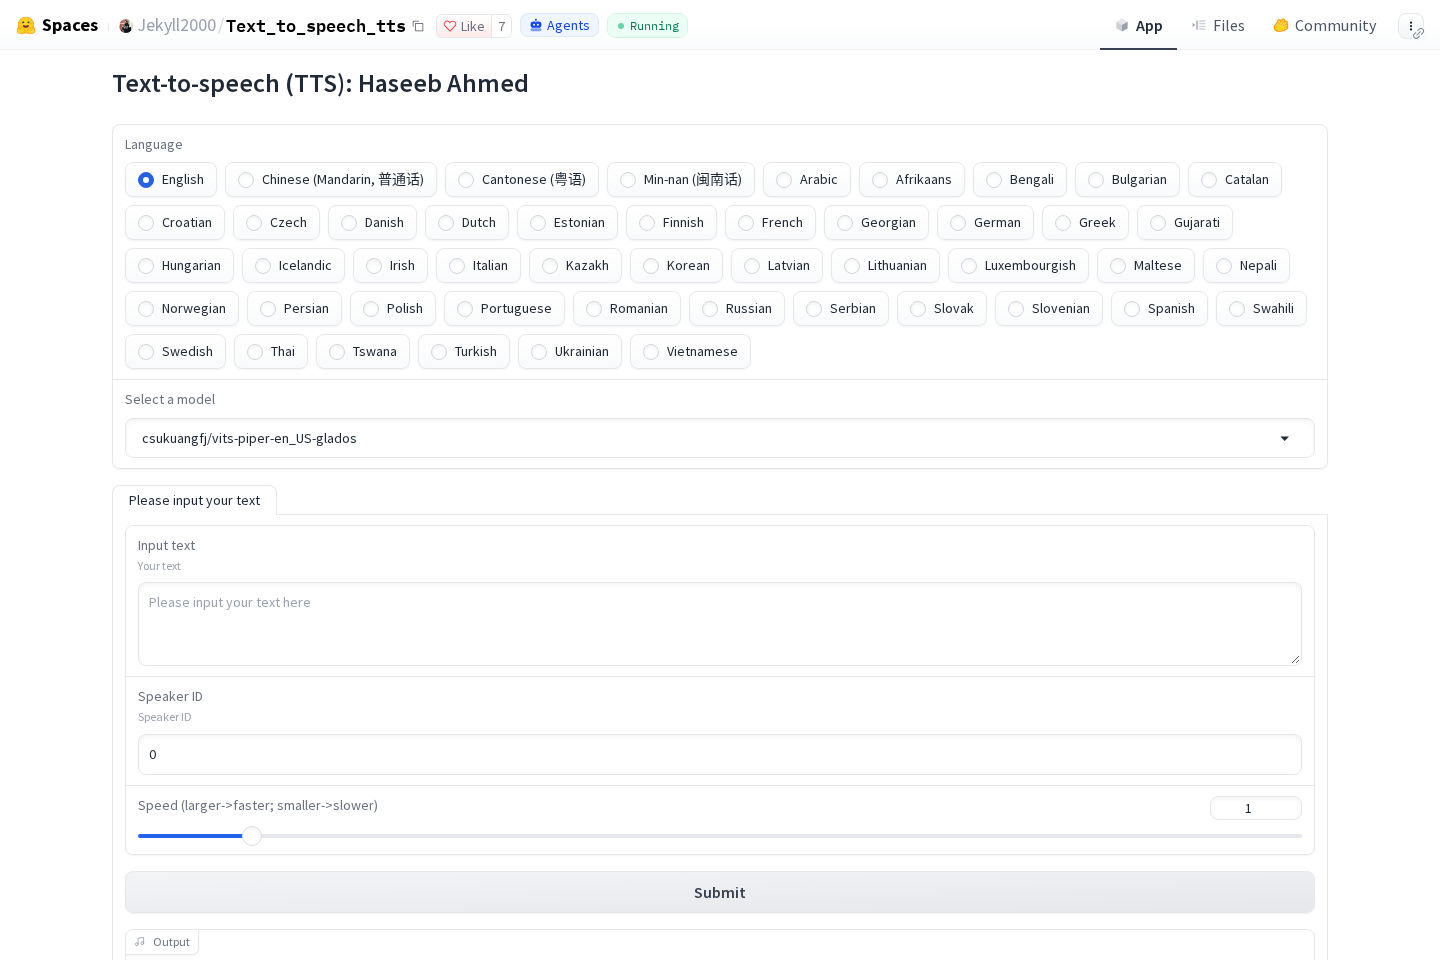
原站网页截图,页面可能随时间更新。
- 作者:Jekyll2000
- 分类:AI 音频
- 名称:Text To Speech Tts
- 来源:Hugging Face Spaces
Text To Speech Tts 将文字输入、语音模型选择和音频输出集中在同一界面中,适合把文本转换为可播放的语音内容。使用时先选择模型,再输入需要合成的文字;如果所选模型支持多说话人设置,还可以填写对应的说话人编号,并按需要调整语速。
主要功能
应用提供语音模型选择、文本输入、说话人编号、语速调节和音频输出等功能。模型选择决定合成时使用的语音模型;文本输入框用于填写待转换内容;速度滑块用于控制播放速度,数值较大时语速更快,数值较小时语速更慢。
适用任务
它适合处理需要将书面文字转换为语音的场景,例如制作可播放的文本内容、试听不同语音模型的效果,或根据不同速度生成更适合聆听的音频。若任务需要区分多个说话人,可以优先考虑支持多说话人的模型,并结合说话人编号进行设置。
使用思路
开始使用时,可先从模型选择项中挑选一个模型,再在文本框中输入完整内容并提交生成。对于支持多说话人的模型,输入有效的说话人编号后再进行合成;如果只是调整听感,可通过速度滑块逐步改变语速。生成后,结果会以音频形式输出,便于直接播放。
参数理解
说话人编号并不是所有模型都适用,它仅对多说话人模型有效,因此是否填写应根据所选模型决定。速度参数只改变语速方向:向较大的数值调整会加快语速,向较小的数值调整会减慢语速。模型、文本和参数之间需要配合设置,才能得到符合预期的输出。
说话人编号什么时候需要填写?
它仅对多说话人模型有效。选择这类模型时,可以填写对应的说话人编号;其他模型不应将该设置视为通用参数。
如何调整生成语音的速度?
使用速度滑块进行调整。数值较大时语速更快,数值较小时语速更慢。