
U
0
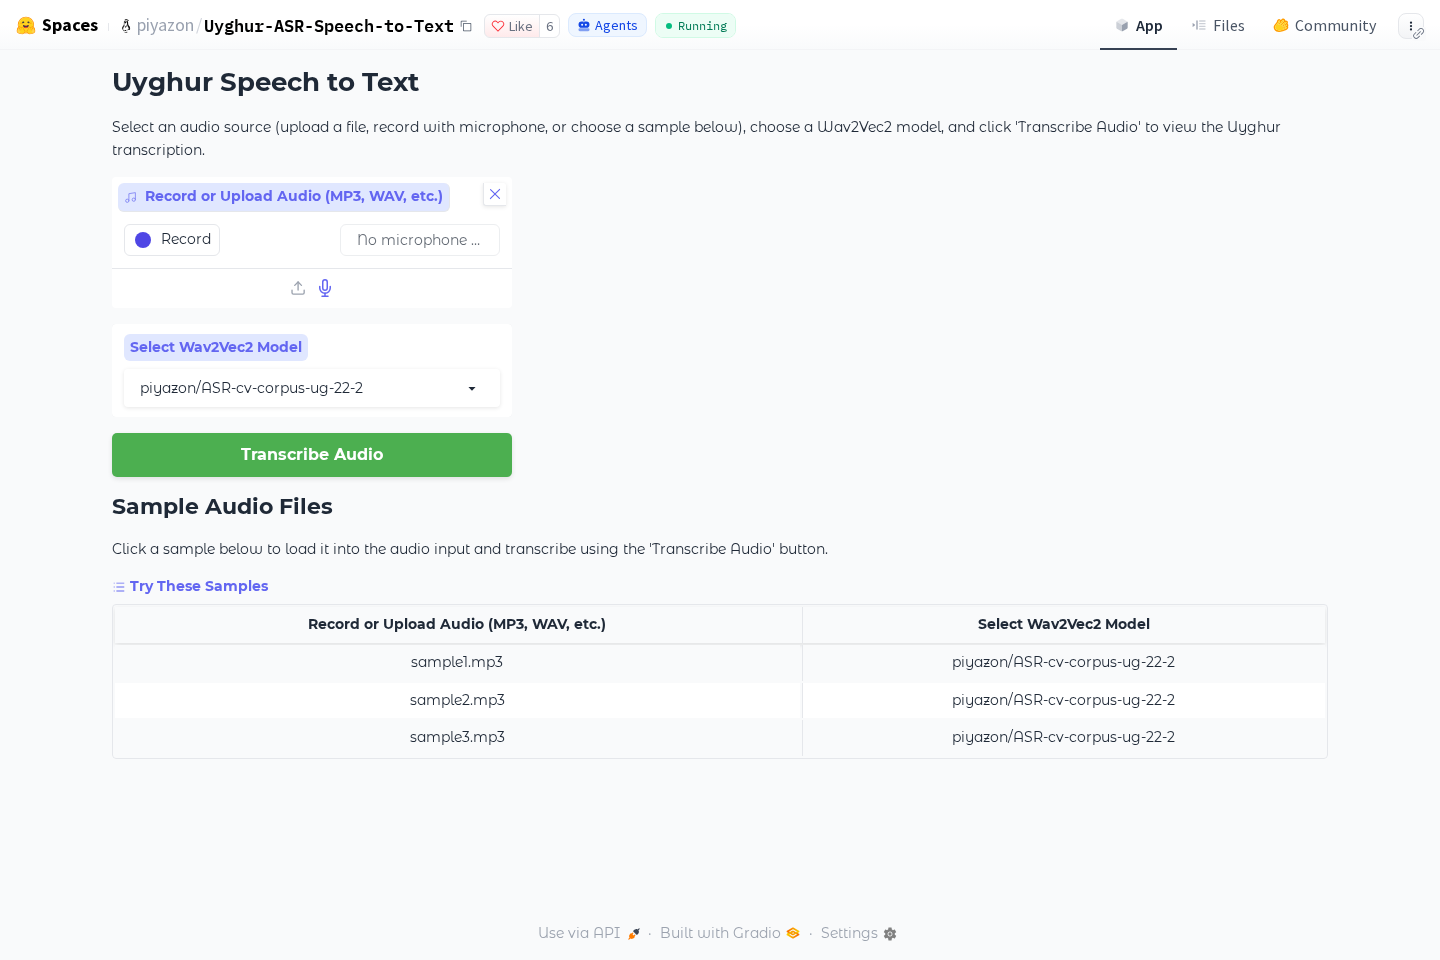
原站网页截图,页面可能随时间更新。
- 代码许可:mit
- 作者:piyazon
- 分类:AI 音频
- 名称:Uyghur ASR Speech To Text
- 来源:Hugging Face Spaces
Uyghur ASR Speech To Text 聚焦维吾尔语语音转文字。使用者可以提供音频来源,选择可用的 Wav2Vec2 模型,再发起转写,以便把语音内容整理为可阅读、可继续编辑的文本。
公开功能
应用支持上传音频文件,也支持通过麦克风录音;界面还提供样例音频入口,便于直接载入示例内容。音频输入支持 MP3、WAV 等格式。完成音频选择后,使用者可以在模型选项中选择一个 Wav2Vec2 模型,并执行音频转写,查看维吾尔语文字结果。
适用任务
它适合将维吾尔语语音记录转换成文字,例如整理录音内容、处理采访或会议中的语音片段,以及对已有音频进行初步文本化。对于需要先获得转写稿、再进行校对、摘录或编辑的工作流程,这类工具可以作为前置环节。
使用思路
使用时可先准备目标音频,并根据来源选择上传文件或麦克风录音;如果只是了解操作方式,也可以先载入样例音频。随后选择合适的 Wav2Vec2 模型并发起转写,再结合原始音频检查输出内容。若录音存在噪声、多人同时说话或发音不清,建议将结果作为初稿进行人工校对。
操作流程
先在音频输入区域上传文件或录制语音,也可以载入一个样例。接着打开模型选择项,选定 Wav2Vec2 模型,点击转写操作,等待结果显示。需要处理多段内容时,可按音频片段分别转写,便于对应原始录音检查和后续整理。
常见问题
可以使用哪些音频来源?
可以上传音频文件,也可以使用麦克风录音;应用还提供样例音频供选择。
支持哪些音频格式?
界面列出了 MP3、WAV 等音频格式。
转写前需要做什么?
需要先提供音频,再选择一个 Wav2Vec2 模型并执行转写。