
K
0
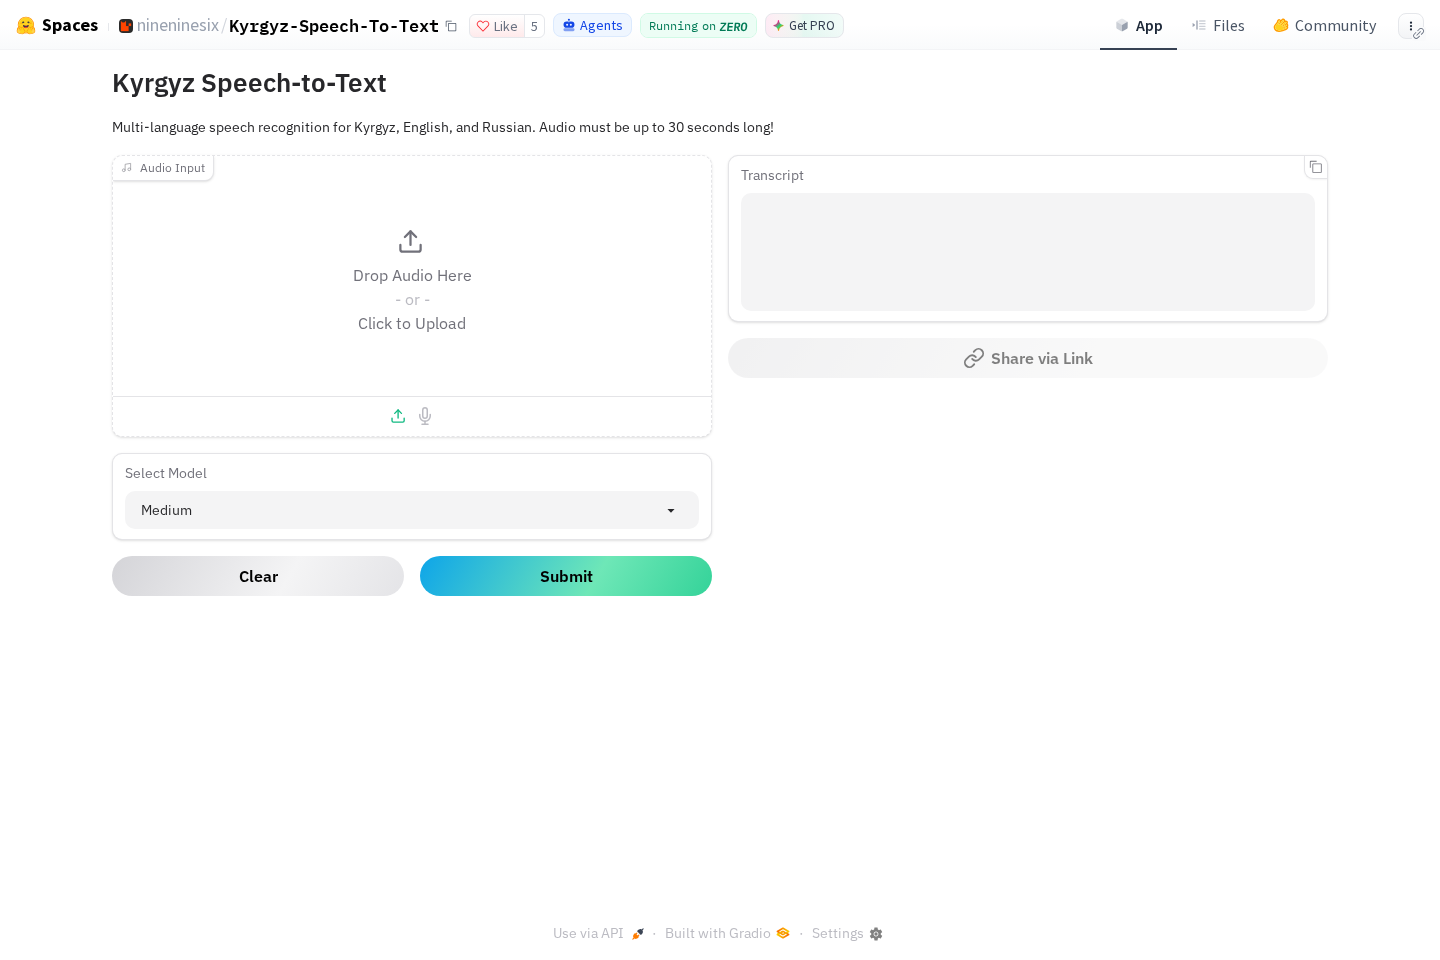
原站网页截图,页面可能随时间更新。
- 代码许可:apache-2.0
- 作者:nineninesix
- 分类:AI 音频
- 名称:Kyrgyz-Speech-To-Text
- 来源:Hugging Face Spaces
Kyrgyz-Speech-To-Text 用于把短音频转换为文字,支持吉尔吉斯语、英语和俄语。使用时提交音频并选择识别模型,应用会将结果呈现在转写区域中;单段音频长度需控制在30秒以内。
支持的语言与用途
该应用面向三种语言的语音识别任务:吉尔吉斯语、英语和俄语。它适合处理较短的语音片段,例如对一段简短录音进行文字整理、提取口述内容,或为后续编辑保留初步文本。页面提供转写结果区域,便于查看识别出的内容。
基本使用思路
使用时,先在音频输入区域提交需要识别的录音,再从模型选择项中选定一个模型,随后获取转写文本。由于单段音频限制为30秒,较长内容可以考虑先按语义或时间切分,再分别处理各段结果,最后结合上下文进行整理。
音频长度与结果整理
音频长度是使用中的关键限制,输入不能超过30秒。对于包含多人对话、背景噪声、方言表达或专有名词的录音,转写内容适合视为初步文本,必要时应结合原始音频进行校对。若要整理成正式稿件,还可以进一步补充标点、分段和说话内容的上下文。
适合的工作场景
这类工具可用于短句听写、语言学习中的听力记录、简短采访片段整理,以及将语音备忘转换为可编辑文字。处理多语言材料时,可以根据录音使用的语言选择合适方向;如果一段音频混用多种语言,建议分段处理并重点检查语言切换处的识别结果。
常见问题
单段音频可以多长?
单段音频最长为30秒,超过这一长度的内容需要先行切分。
支持哪些语言?
支持吉尔吉斯语、英语和俄语的语音识别。
使用时需要安装软件吗?
该应用可在浏览器中使用,不需要安装本地软件。