
t
0
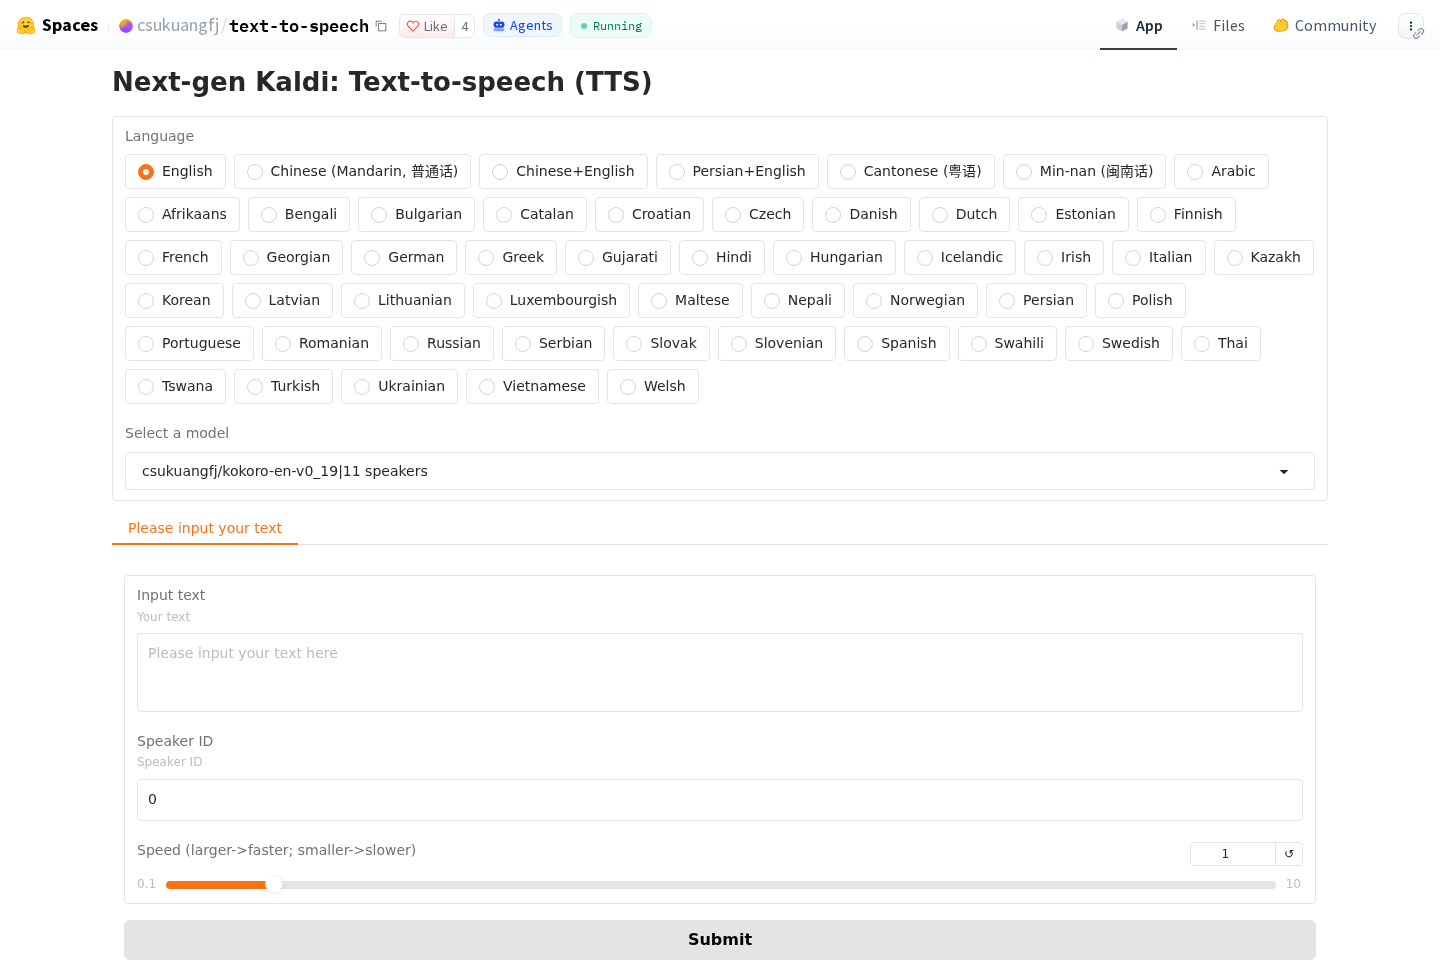
原站网页截图,页面可能随时间更新。
- 代码许可:apache-2.0
- 作者:csukuangfj
- 分类:AI 音频
- 名称:tts Text To Speech
- 来源:Hugging Face Spaces
该应用围绕文本转语音这一核心任务设计:用户选择模型后输入文本,设置语速,并获取音频结果。它适合需要把书面内容转换为语音的场景,具体效果取决于所选模型及输入内容。
核心功能
应用提供模型选择、文本输入、语速调节和音频输出等功能。文本输入框用于填写需要转换的内容,语速滑块用于控制合成语音的快慢,完成设置后可通过操作生成音频。
适用任务
它适合处理将文字内容转换为可播放语音的任务,例如把一段准备好的文字交给语音合成流程处理。对于需要不同语音模型的任务,可以先在模型选择项中切换,再根据需要调整语速。
使用思路
使用时可先选择合适的模型,再在文本框中输入待转换文字。若使用的是多说话人模型,还可以填写说话人编号;该编号只对多说话人模型有效。随后通过语速设置调整播放节奏,并提交生成音频。
设置说明
语速设置遵循滑块提示:数值较大时语音更快,数值较小时语音更慢。说话人编号并非所有模型都适用,因此只有在使用多说话人模型时才建议配置这一项。
说话人编号什么时候有效?
说话人编号仅对多说话人模型有效。使用其他类型模型时,不应将该设置视为通用选项。
如何调整生成语音的快慢?
使用语速滑块进行调整:数值较大表示更快,数值较小表示更慢。